
Crawler / Crawling
Ein Crawler ruft Webseiten automatisch ab und folgt Links. Wie Googlebot, Bingbot und KI-Crawler arbeiten und was Industrie-Websites daraus ableiten sollten.
Ein Crawler, auch Webcrawler, Bot oder Spider genannt, ist ein Programm, das Webseiten automatisch abruft, den Links darauf folgt und die Inhalte für einen Suchindex, ein Archiv oder das Training von KI-Modellen sammelt. Crawling ist der erste Schritt, bevor eine Seite in der Google-Suche oder als Quelle in einer KI-Antwort erscheinen kann.
Im Maschinenbau ist das Wort doppelt belegt: Ein Crawler ist dort auch ein Raupenfahrwerk, etwa beim Raupenkran. In diesem Eintrag geht es um die Software, die das Web liest.
Wie Crawling funktioniert
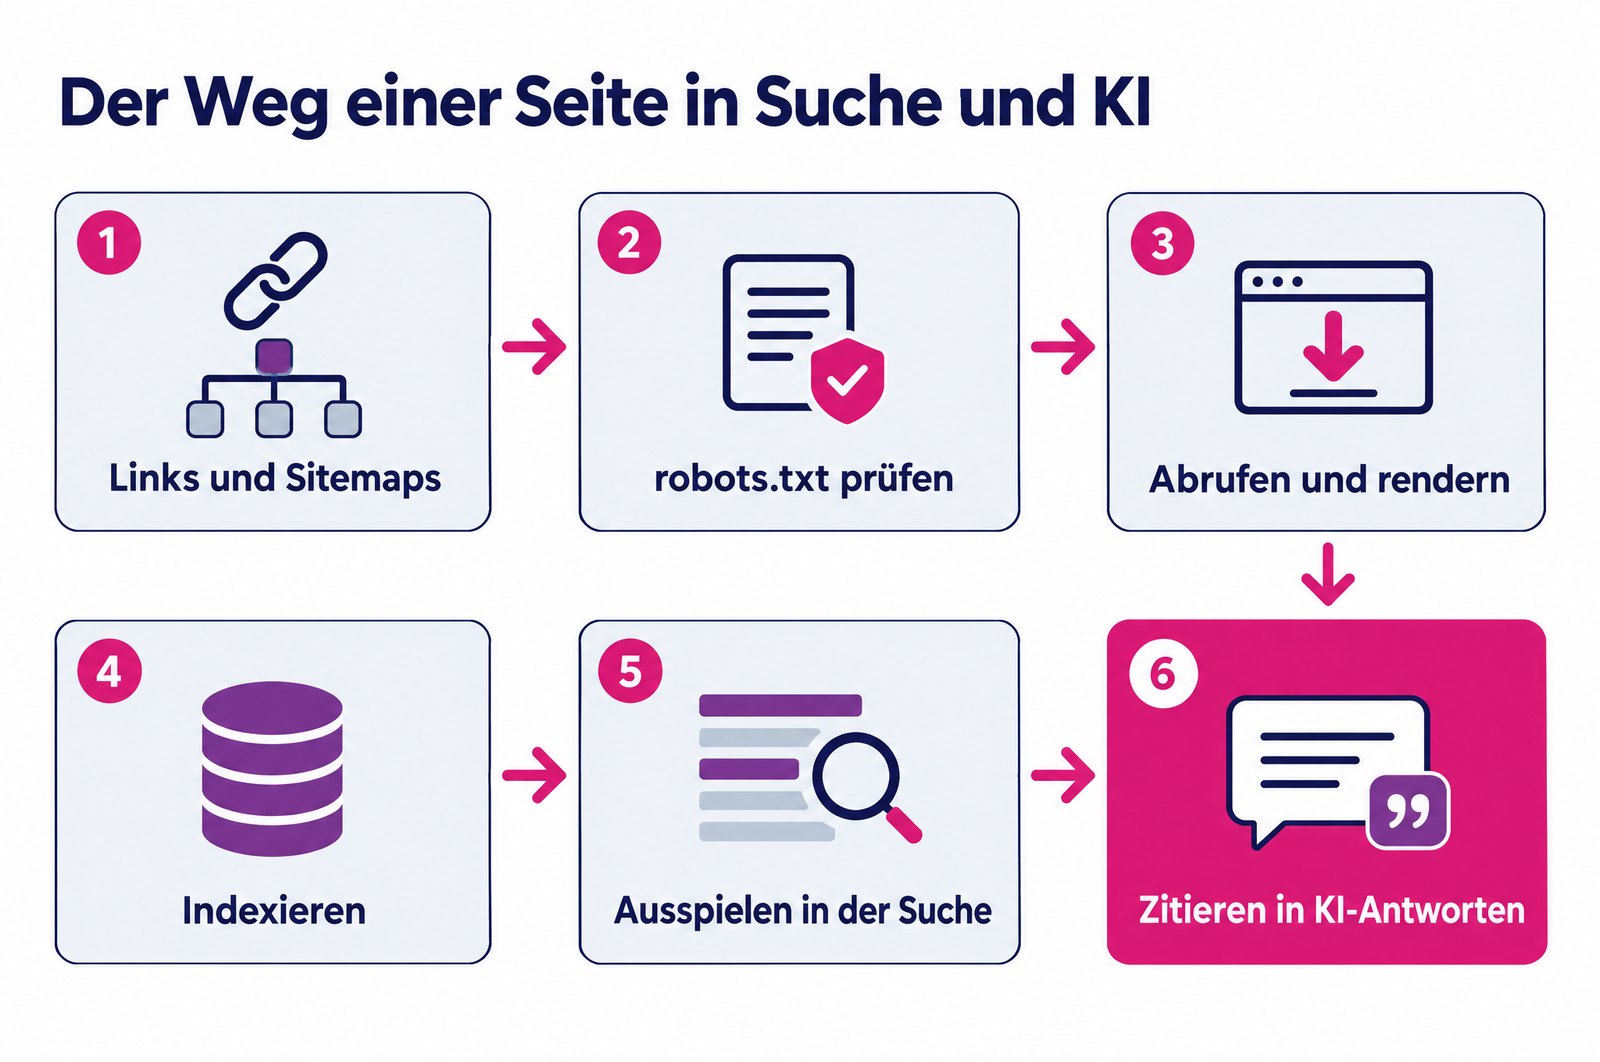
Ein Crawler braucht zuerst Adressen. Google findet neue Seiten laut eigener Dokumentation auf drei Wegen: über bereits bekannte Seiten, über Links von dort zu neuen Seiten und über Sitemaps, die Website-Betreiber einreichen. Die gefundenen Adressen landen in einer Warteschlange. Bevor der Crawler eine Seite abruft, liest er die robots.txt der Website und prüft, ob der Abruf erlaubt ist.
Dann folgt der eigentliche Abruf per HTTP. Google rendert die Seite anschließend mit einer aktuellen Chrome-Version und führt dabei JavaScript aus, ähnlich wie ein Browser. Der Googlebot ruft laut Dokumentation vom Februar 2026 bei HTML-Dateien die ersten 2 MB ab, bei PDF-Dateien die ersten 64 MB; was darüber hinausgeht, wird nicht berücksichtigt. Für typische Seiten ist das unkritisch, aufgeblähte Seiten mit eingebetteten Daten können die Grenze erreichen.
Gute Crawler nehmen Rücksicht auf den Server. Laut Google sollte der Googlebot die meisten Websites im Schnitt nicht öfter als alle paar Sekunden abrufen, und er verlangsamt, wenn ein Server mit Fehlern antwortet. Die meisten Abrufe erfolgen mit dem Smartphone-Crawler, weil Google überwiegend die mobile Fassung einer Seite indexiert. Häufigeres Crawling lässt sich nicht kaufen: Google nimmt nach eigener Aussage kein Geld dafür, eine Website öfter zu crawlen oder besser zu platzieren.
Welche Crawler eine Industrie-Website besuchen
Wer in die Server-Logs schaut, findet Dutzende Kennungen. Für die Sichtbarkeit in Suche und KI-Antworten sind wenige entscheidend.
| Kennung | Betreiber | Aufgabe laut Anbieter | Bedeutung für Sichtbarkeit |
|---|---|---|---|
| Googlebot | Google-Suche einschließlich AI Overviews und AI Mode | Grundvoraussetzung für Google | |
| Bingbot | Microsoft | Bing-Suche, gemeinsame Grundlage mit Copilot | Bing und Copilot |
| OAI-SearchBot | OpenAI | Websites in den Suchfunktionen von ChatGPT anzeigen | Quelle in ChatGPT-Suchantworten |
| GPTBot | OpenAI | Inhalte für das Training von Basismodellen | kein direkter Einfluss auf die ChatGPT-Suche |
| ChatGPT-User | OpenAI | Abruf bei Nutzeraktionen | robots.txt gilt laut OpenAI möglicherweise nicht |
| PerplexityBot | Perplexity | Websites in Perplexity-Ergebnissen anzeigen, kein Training | Quelle in Perplexity |
| CCBot | Common Crawl | offenes Web-Archiv | indirekt, Archiv wird von Dritten genutzt |
Dazu kommen Crawler von SEO-Tools, Preisvergleichen und Monitoring-Diensten sowie Audit-Crawler, die Sie selbst starten, um die eigene Website zu prüfen.
Crawling, Indexierung, Ranking
Die drei Begriffe werden oft vermischt. Google beschreibt die Suche in drei Stufen: Crawling lädt Texte, Bilder und Videos herunter. Die Indexierung analysiert den Inhalt, wählt bei Duplikaten eine kanonische Fassung und speichert das Ergebnis. Die Ausspielung entscheidet, welche Seiten für eine Suchanfrage erscheinen. Zwischen den Stufen geht etwas verloren: Laut Google wird nicht jede verarbeitete Seite indexiert.
Bei KI-Antworten kommt eine vierte Stufe hinzu. Systeme mit Websuche holen passende Seiten aus ihrem Index und formulieren daraus eine Antwort, ein Verfahren namens Retrieval-Augmented Generation. Auch Googles AI Overviews arbeiten laut Google auf dieser Grundlage. Was nie gecrawlt wurde, kann deshalb auch nicht zitiert werden. Was ein Large Language Model ohne Websuche über ein Unternehmen weiß, stammt dagegen aus Trainingsdaten. Auch die sammeln Anbieter mit eigenen Crawlern, OpenAI etwa dokumentiert dafür den GPTBot.
Was KI-Crawler anders machen
Die großen KI-Anbieter betreiben getrennte Kennungen für getrennte Aufgaben: Training, Suchindex und Abrufe auf Nutzerwunsch. Wer eine Kennung sperrt, sollte wissen, welche Aufgabe dahintersteht, sonst verschwindet er im ungünstigsten Fall aus der ChatGPT-Suche, obwohl er nur das Training unterbinden wollte. Diese Abwägung behandelt der Ratgeber zu KI-Crawlern und robots.txt ausführlich. Agenten, die im Auftrag eines Nutzers Websites bedienen, beschreibt der Beitrag zu KI-Browsern und Agenten.
Ein zweiter Unterschied betrifft JavaScript. Google rendert Seiten. Wie gut andere Crawler das tun, legen die Anbieter nicht vollständig offen. Inhalte, die im ausgelieferten HTML stehen, kann dagegen jeder Crawler lesen.
Crawler in der Industrie-Praxis
Ein konstruiertes Beispiel: Ein Sondermaschinenbauer wundert sich, dass neue Referenzseiten erst nach Wochen bei Google auftauchen. Der Bericht Crawling-Statistik in der Search Console zeigt das Muster: Ein großer Teil der Abrufe entfällt auf Kalender- und Filteradressen eines alten Veranstaltungsmoduls, die sich endlos kombinieren lassen. Die Referenzseiten selbst sind nur über ein JavaScript-Menü verlinkt, und die technischen Daten stehen ausschließlich in PDF-Dateien.
Die Lösung besteht aus drei Schritten. Das Veranstaltungsmodul wird entfernt, die alten Adressen liefern einen 404- oder 410-Status. Die Referenzseiten erhalten normale HTML-Links aus Navigation und Leistungsseiten und stehen in der Sitemap. Die wichtigsten Kennwerte wandern aus dem PDF in den Seitentext. Zusätzlich prüft die IT in den Logs, ob neben dem Googlebot auch Bingbot, OAI-SearchBot und PerplexityBot ankommen und welche Statuscodes sie erhalten. Dabei fällt auf, dass ein Bot-Schutz beim Hoster einzelne KI-Crawler abweist, ohne dass die robots.txt davon etwas zeigt.
So prüfen Sie das Crawling
Für Google gibt es eine direkte Datenquelle. Der Bericht Crawling-Statistik in der Search Console, zu finden unter Einstellungen, zeigt für die letzten 90 Tage die Zahl der Crawling-Anfragen, die heruntergeladene Datenmenge, die durchschnittliche Antwortzeit und den Host-Status. Er schlüsselt die Abrufe nach Antwortcode, Dateityp, Zweck und Googlebot-Typ auf. Beim Zweck unterscheidet Google zwischen dem Auffinden neuer Adressen und dem Aktualisieren bekannter Seiten. Google richtet den Bericht ausdrücklich an fortgeschrittene Nutzer; für Websites mit weniger als 1.000 Seiten sei er in der Regel nicht nötig.
Für alle anderen Crawler bleiben die Server-Logs. Sie zeigen, welche Kennung wann welche Adresse abgerufen hat und welchen Statuscode sie bekam. In unserer Studie mit 41 Industrie-Websites sperrte nur eine Website KI-Crawler per robots.txt. Ob die Crawler tatsächlich ankommen, beantwortet die robots.txt allerdings nicht, das zeigen nur die Logs.
Häufige Fehler
- Der Kennung vertrauen. Jeder kann sich als Googlebot ausgeben. Google empfiehlt die Prüfung per Reverse-DNS oder über die veröffentlichten IP-Bereiche.
- Endlose URL-Räume. Filter, Sortierungen und Kalender erzeugen unzählige Adressen, die Abrufe binden, ohne Mehrwert zu bringen.
- Inhalte nur im PDF oder im Skript. Was nicht im HTML steht, ist für manche Crawler unsichtbar und für alle schwerer auszuwerten.
- Sperren außerhalb der robots.txt. Firewall, CDN und Bot-Schutz können Crawler blockieren, ohne dass es jemand bemerkt.
- Serverfehler ignorieren. Häufen sich 5xx-Antworten, drosselt Google das Crawling.
Ob die Crawler bei Ihnen ankommen, ist der erste Prüfpunkt jeder Bestandsaufnahme, wie das GEO-Audit zeigt. Wie wir Technik und Inhalte so aufstellen, dass Suchmaschinen und KI-Systeme Ihr Angebot finden, beschreibt unsere Seite zu KI-SEO.
Quellen
- Google Search Central: In-depth guide to how Google Search works (Stand 18.12.2025)
- Google Search Central: Googlebot (Stand 03.02.2026)
- Google Search Console-Hilfe: Bericht „Crawling-Statistik“
- Google Search Central: Optimizing your website for generative AI features on Google Search (veröffentlicht 15.05.2026)
- OpenAI: Overview of OpenAI Crawlers
- Perplexity: Perplexity Crawlers
- Bing Webmaster Guidelines
- Common Crawl: CCBot
Häufige Fragen zu Crawler / Crawling
Was ist ein Crawler?
Ein Crawler, auch Webcrawler, Bot oder Spider genannt, ist ein Programm, das Webseiten automatisch abruft, den Links darauf folgt und die gefundenen Inhalte weitergibt. Suchmaschinen bauen daraus ihren Index auf, KI-Anbieter ihren Suchindex oder Trainingsdaten. Ohne Crawling kann eine Seite weder in der Google-Suche noch als Quelle in einer KI-Antwort erscheinen.
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling ist der Abruf einer Seite, Indexierung ihre Auswertung und Speicherung im Suchindex. Google beschreibt drei Stufen: Crawling, Indexierung und Ausspielung. Nicht jede gecrawlte Seite wird indexiert. Ob Google eine Seite aufnimmt, hängt unter anderem von ihrer Qualität, von Duplikaten und von Angaben wie noindex ab. Ein Abruf durch den Googlebot ist also eine Voraussetzung, keine Zusage.
Wie erkenne ich, ob wirklich der Googlebot meine Website besucht?
Die Kennung im User-Agent lässt sich leicht fälschen. Google empfiehlt deshalb, die IP-Adresse eines Zugriffs per Reverse-DNS-Abfrage zu prüfen oder mit den veröffentlichten IP-Bereichen von Google abzugleichen. OpenAI und Perplexity veröffentlichen ebenfalls IP-Listen für ihre Crawler. In der Search Console zeigt der Bericht Crawling-Statistik für die letzten 90 Tage, wie oft Google Ihre Website abgerufen hat.
Was ist ein KI-Crawler?
Ein KI-Crawler ist ein Crawler eines KI-Anbieters. Die großen Anbieter trennen dabei Aufgaben: Trainings-Crawler wie GPTBot sammeln Inhalte für künftige Modelle, Such-Crawler wie OAI-SearchBot oder PerplexityBot bauen den Index für die Websuche im Assistenten auf, und nutzergesteuerte Abrufe holen eine Seite, wenn ein Mensch danach fragt. Für Sichtbarkeit in KI-Antworten zählen vor allem die Such-Crawler.
Kann ich steuern, wie oft Google meine Website crawlt?
Nur begrenzt. Google passt die Crawling-Frequenz an die Leistungsfähigkeit des Servers und an den Bedarf an. Laut Google sollte der Googlebot die meisten Websites im Schnitt nicht öfter als alle paar Sekunden abrufen. Bezahlen lässt sich häufigeres Crawling nicht. Wirksam sind schnelle Serverantworten, wenige überflüssige URL-Varianten, eine aktuelle Sitemap und eine klare interne Verlinkung.
Diesen Begriff in Ergebnisse übersetzen? Das übernehmen wir im Bereich SEO & Content.