
Keyword-Kannibalisierung
Keyword-Kannibalisierung: Mehrere eigene Seiten konkurrieren um dieselbe Suchanfrage. Woran Sie das erkennen und wie Sie es im B2B sauber auflösen.
Keyword-Kannibalisierung liegt vor, wenn mehrere Seiten derselben Website dieselbe Suchintention bedienen und dadurch um dieselben Suchanfragen konkurrieren. Google zeigt dann abwechselnd verschiedene oder die falsche Seite, und keine von ihnen bündelt die Signale, die eine einzelne starke Seite hätte.
Wie Kannibalisierung entsteht und was Google daraus macht
Kannibalisierung ist selten eine bewusste Entscheidung, sondern das Ergebnis gewachsener Websites. Auf einer typischen Industrie-Website stehen zum selben Thema eine Leistungsseite, ein älterer Blogartikel, ein Messebericht, eine News zur neuen Anlage und vielleicht noch eine Stadtseite aus einer früheren SEO-Phase. Nach einem Relaunch kommen oft alte und neue Fassungen derselben Seite hinzu. Jede dieser Seiten ist für sich vertretbar, zusammen verwirren sie.
Google verwendet den Begriff „Kannibalisierung“ nicht. Die Dokumentation beschreibt aber drei Mechanismen, die das Phänomen erklären. Erstens das System für Website-Vielfalt: Google zeigt nach eigener Aussage in der Regel nicht mehr als zwei Ergebnisse derselben Website in den Top-Ergebnissen, außer wenn es für eine Suche besonders relevant erscheint. Zweitens die Deduplizierung: Sehr ähnliche Ergebnisse werden zusammengefasst, damit sich die Trefferliste nicht wiederholt. Drittens die Kanonisierung: Google gruppiert Seiten mit ähnlichem Inhalt und wählt diejenige aus, die die Gruppe am besten repräsentiert.
Für den Website-Betreiber heißt das: Google entscheidet, welche der konkurrierenden Seiten erscheint, und diese Entscheidung kann von Woche zu Woche anders ausfallen. Interne Links, externe Verweise und Nutzersignale verteilen sich auf mehrere Adressen. Am Ende rankt eine mittelmäßige Seite auf Position 14, wo eine zusammengeführte Seite auf Position 5 stehen könnte.
Echte und scheinbare Kannibalisierung
Nicht jede Doppelung ist ein Problem. Zwei eigene Ergebnisse auf der ersten Seite der SERP sind ein Erfolg. Entscheidend ist, ob die Seiten dieselbe Suchintention bedienen und ob dadurch die richtige Seite verdrängt wird.
| Beobachtung | Kannibalisierung? | Was zu tun ist |
|---|---|---|
| Zwei URLs wechseln sich für dieselbe Anfrage ab, die Position schwankt | ja | zusammenführen oder Rollen klar trennen |
| Ein Fachartikel rankt für eine Kaufanfrage, die Produktseite nicht | ja, Intention verfehlt | Produktseite ausbauen, Artikel verlinkt auf sie |
| Startseite und Kontaktseite erscheinen beim Firmennamen | nein | nichts, das ist normal |
| Zwei eigene Seiten stehen stabil gemeinsam in den Top 5 | nein | beobachten, beide behalten |
| Fast gleiche Seiten für Synonyme oder Städte ohne Standort | ja, dazu Spam-Risiko | auf eine Seite zurückführen |
| Definition und Praxisartikel zum selben Thema | nur bei gleicher Intention | unterschiedliche Fragen und Ziel-Keywords festlegen |
So erkennen Sie Kannibalisierung
Das wichtigste Werkzeug ist der Leistungsbericht der Google Search Console. Filtern Sie nach einer Suchanfrage, die Ihnen wichtig ist, und wechseln Sie auf den Tab „Seiten“. Erscheinen dort mehrere URLs mit Impressionen, vergleichen Sie zwei Zeiträume: Wechselt die Seite mit den meisten Impressionen, schwankt Google zwischen ihnen. Für eine systematische Prüfung exportieren Sie Suchanfragen und Seiten gemeinsam und sortieren nach Anfragen mit zwei oder mehr URLs. Websites mit sehr vielen Anfragen können zusätzlich die „Query groups“ nutzen, die Google seit Oktober 2025 in den Search-Console-Insights anbietet und die ähnliche Formulierungen bündeln.
Ein zweites Signal ist die Klickrate. Zeigt Google für eine kaufnahe Anfrage den Blogartikel statt der Leistungsseite, bleiben die Klicks oft aus, weil der Treffer nicht zur Erwartung passt. Ergänzend helfen eine site-Abfrage mit dem Suchbegriff und ein Crawl, der doppelte Seitentitel und H1-Überschriften auflistet. Gleiche Titel auf verschiedenen Seiten sind fast immer ein Hinweis auf gleiche Ziele.
Keyword-Kannibalisierung in der Industrie-Praxis
Ein fiktives Beispiel: Ein Lohnbeschichter hat eine Leistungsseite „Pulverbeschichtung“, einen Blogartikel „Was ist Pulverbeschichtung?“ von 2019, eine News zur neuen Einbrennofen-Anlage und eine Seite „Pulverbeschichtung Stuttgart“, obwohl das Werk 40 Kilometer entfernt liegt. In der Search Console wechseln sich für „pulverbeschichtung lohnbeschichtung“ drei dieser URLs ab, keine kommt über die zweite Ergebnisseite hinaus.
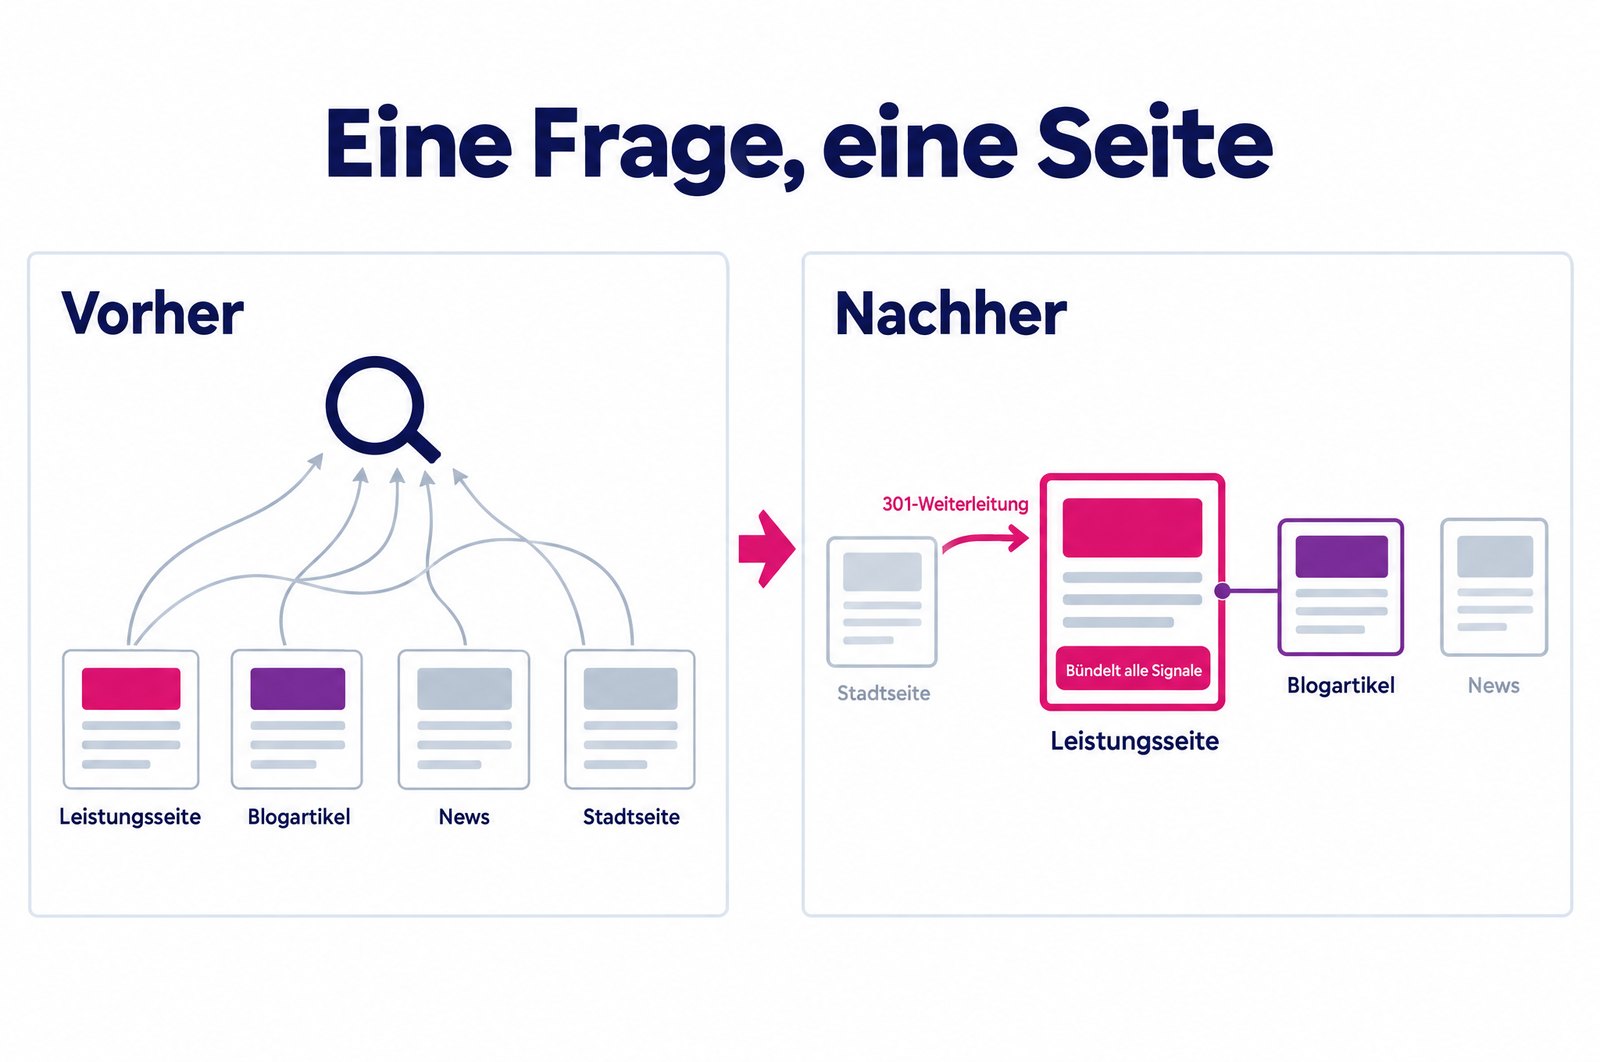
Die Bereinigung folgt der Logik „eine Frage, eine Seite“. Die Stadtseite hat keinen eigenen Inhalt; ihre wenigen brauchbaren Absätze wandern in die Leistungsseite, die Adresse wird dauerhaft per 301 weitergeleitet. Der Blogartikel wird neu ausgerichtet: Statt die Leistung zu wiederholen, beantwortet er die Fragen der Konstruktion zu Schichtdicken, Vorbehandlung und Maßtoleranzen und verlinkt mit klarem Ankertext auf die Leistungsseite. Die News bleibt News. Die Leistungsseite selbst bekommt, was ihr fehlte: maximale Teilemaße, Farbtonsysteme, Losgrößen und ein Referenzprojekt. Ziel ist, dass für die Kernanfrage genau eine Seite alle Signale bündelt.
Die üblichen Werkzeuge im Überblick:
- Zusammenführen und weiterleiten: für Seiten mit gleicher Aufgabe. Die schwächere Adresse leitet dauerhaft auf die stärkere weiter, damit Links und Lesezeichen erhalten bleiben.
- Differenzieren: für Seiten mit unterschiedlichem Leser. Jede Seite bekommt eine eigene Frage und ein eigenes Ziel-Keyword.
- Canonical: nur für Beinahe-Duplikate, etwa Druckversionen oder Parameter-URLs. Google wertet es als starkes Signal, nicht als Befehl.
- Noindex: für Seiten, die Nutzer brauchen, die aber nicht in der Suche erscheinen sollen, etwa Kampagnenseiten.
Was Kannibalisierung für die KI-Suche bedeutet
Google empfiehlt im Leitfaden zur KI-Suche vom Mai 2026, doppelte Inhalte zu reduzieren, und stuft Seiten für jede Suchvariante, die vorrangig der Manipulation dienen, als Spam-Risiko ein. Viele Fälle von Kannibalisierung entstehen genau so: aus dem Versuch, jedes Long-Tail-Keyword mit einer eigenen Seite abzudecken. Die KI-Funktionen der Google-Suche holen ihre Quellen laut Google über die Ranking-Systeme, ein Verfahren nach dem Prinzip der Retrieval-Augmented Generation. Konkurrieren drei halbe Seiten, steigt nach unserer Einschätzung das Risiko, dass eine schwächere oder veraltete Passage in der Antwort landet.
Wir halten es auf dieser Website selbst so: Begriffe, die ein Ratgeber bereits abdeckt, etwa die Keyword-Recherche, bekommen im Glossar keine eigene Seite, sondern einen Verweis im A–Z-Register. Wo Glossar und Ratgeber dasselbe Thema berühren, definiert der Glossar-Eintrag den Begriff, und der Ratgeber erklärt die Praxis, mit jeweils eigenem Ziel-Keyword.
Häufige Fehler
- Jede Doppelung für ein Problem halten: Zwei stabile Top-Ergebnisse sind kein Fall für die Bereinigung.
- Seiten löschen statt weiterleiten: Ohne Weiterleitung gehen eingehende Links verloren, und Besucher landen auf einer Fehlerseite.
- Canonical auf inhaltlich verschiedene Seiten: Google ignoriert das Signal dann häufig oder wählt selbst.
- Das Problem mit noch einer Seite lösen: Ein neuer „Komplettleitfaden“ neben drei alten Artikeln verschärft die Konkurrenz.
- Widersprüchliche interne Links: Wenn derselbe Ankertext auf verschiedene Ziele zeigt, fehlt Google die klare Zuordnung.
Welche Seite für welchen Begriff stehen soll, ist der erste Hebel im Ratgeber Google-Ranking verbessern. Wenn Sie Ihre Website auf solche Überschneidungen prüfen lassen wollen, ist das ein fester Bestandteil unserer SEO-Betreuung und der Arbeit als SEO-Agentur für Industrieunternehmen.
Quellen
- Google Search Central: Leitfaden zu den Ranking-Systemen der Google-Suche, Abschnitte zur Website-Vielfalt und Deduplizierung, Stand 10.12.2025
- Google Search Central: So funktioniert die Google-Suche, Abschnitt Indexierung und Kanonisierung, Stand 18.12.2025
- Google Search Central: Kanonische URLs angeben, Stand 10.07.2026
- Google Search Central: Optimizing your website for generative AI features on Google Search, veröffentlicht am 15.05.2026
- Google Search Central Blog: Introducing Query groups in Search Console Insights, 27.10.2025
Häufige Fragen zu Keyword-Kannibalisierung
Was ist Keyword-Kannibalisierung?
Keyword-Kannibalisierung liegt vor, wenn mehrere Seiten derselben Website dieselbe Suchintention bedienen und dadurch um dieselben Suchanfragen konkurrieren. Google wählt dann eine davon aus, oft abwechselnd oder die falsche. Links, Klicks und inhaltliche Signale verteilen sich auf mehrere schwache Seiten, statt eine starke Seite zu stützen. Eine Strafe ist das nicht, aber verschenktes Potenzial.
Wie erkenne ich Keyword-Kannibalisierung?
Am zuverlässigsten in der Google Search Console. Filtern Sie im Leistungsbericht nach einer Suchanfrage und wechseln Sie auf den Tab „Seiten“. Erhalten mehrere URLs Impressionen für dieselbe Anfrage und wechseln sich über die Zeit ab, ist das ein starkes Indiz. Ergänzend helfen eine site-Abfrage bei Google und ein Crawl, der doppelte Seitentitel und Überschriften aufdeckt.
Ist es schlimm, wenn zwei eigene Seiten für dasselbe Keyword ranken?
Nicht unbedingt. Stehen beide Seiten stabil weit oben, ist das ein Erfolg. Google zeigt laut eigener Dokumentation in der Regel höchstens zwei Ergebnisse derselben Website in den Top-Ergebnissen. Problematisch wird es, wenn die Positionen schwanken, die falsche Seite erscheint oder keine der beiden Seiten die Anfrage vollständig beantwortet.
Wie behebe ich Keyword-Kannibalisierung?
Je nach Fall auf eine von vier Arten: Seiten mit gleicher Aufgabe zusammenführen und die alte Adresse dauerhaft per 301 weiterleiten, Seiten klar auf unterschiedliche Suchintentionen ausrichten, bei Beinahe-Duplikaten ein Canonical setzen oder Seiten, die nur für Nutzer gedacht sind, auf noindex stellen. Danach die internen Links so anpassen, dass sie auf die gewünschte Zielseite zeigen.
Kann Kannibalisierung die Sichtbarkeit in KI-Antworten beeinflussen?
Indirekt ja. Google empfiehlt im Leitfaden zur KI-Suche vom Mai 2026 ausdrücklich, doppelte Inhalte zu reduzieren. Die KI-Funktionen holen ihre Quellen über die Ranking-Systeme der Suche. Gibt es drei halbe Seiten statt einer vollständigen, steigt nach unserer Einschätzung das Risiko, dass eine schwächere oder veraltete Passage in der Antwort landet.
Diesen Begriff in Ergebnisse übersetzen? Das übernehmen wir im Bereich SEO & Content.