
RAG (Retrieval-Augmented Generation)
RAG erklärt: wie KI-Suchen und Firmen-Chatbots vor der Antwort Quellen abrufen, was Google dazu sagt und was das für die KI-Sichtbarkeit Ihrer Firma heißt.
RAG (Retrieval-Augmented Generation) ist ein Verfahren, bei dem ein Sprachmodell vor dem Antworten passende Textpassagen aus einer externen Quelle abruft, etwa aus einem Suchindex oder einer Dokumentensammlung, und seine Antwort auf diese Passagen stützt. So verbindet es gelerntes Sprachwissen mit aktuellen, überprüfbaren Quellen.
Der Begriff stammt aus einer Forschungsarbeit von Patrick Lewis und Kollegen, die im Mai 2020 erschien und auf der Konferenz NeurIPS 2020 vorgestellt wurde. Die Autoren kombinierten ein Sprachmodell mit einem durchsuchbaren Textbestand, damit das Modell Fakten nachschlagen kann, statt sich nur auf das zu verlassen, was beim Training in seinen Parametern hängen geblieben ist. Heute steckt dieses Prinzip in fast jeder KI-Suche: in den AI Overviews und im AI Mode von Google, in ChatGPT mit Websuche und in Perplexity. Für Industrieunternehmen hat RAG deshalb zwei Seiten. Es entscheidet, ob Ihre Website in KI-Antworten vorkommt, und es ist die gängige Technik, mit der Sie eigene Assistenten auf Ihr Firmenwissen setzen.
Wie RAG funktioniert
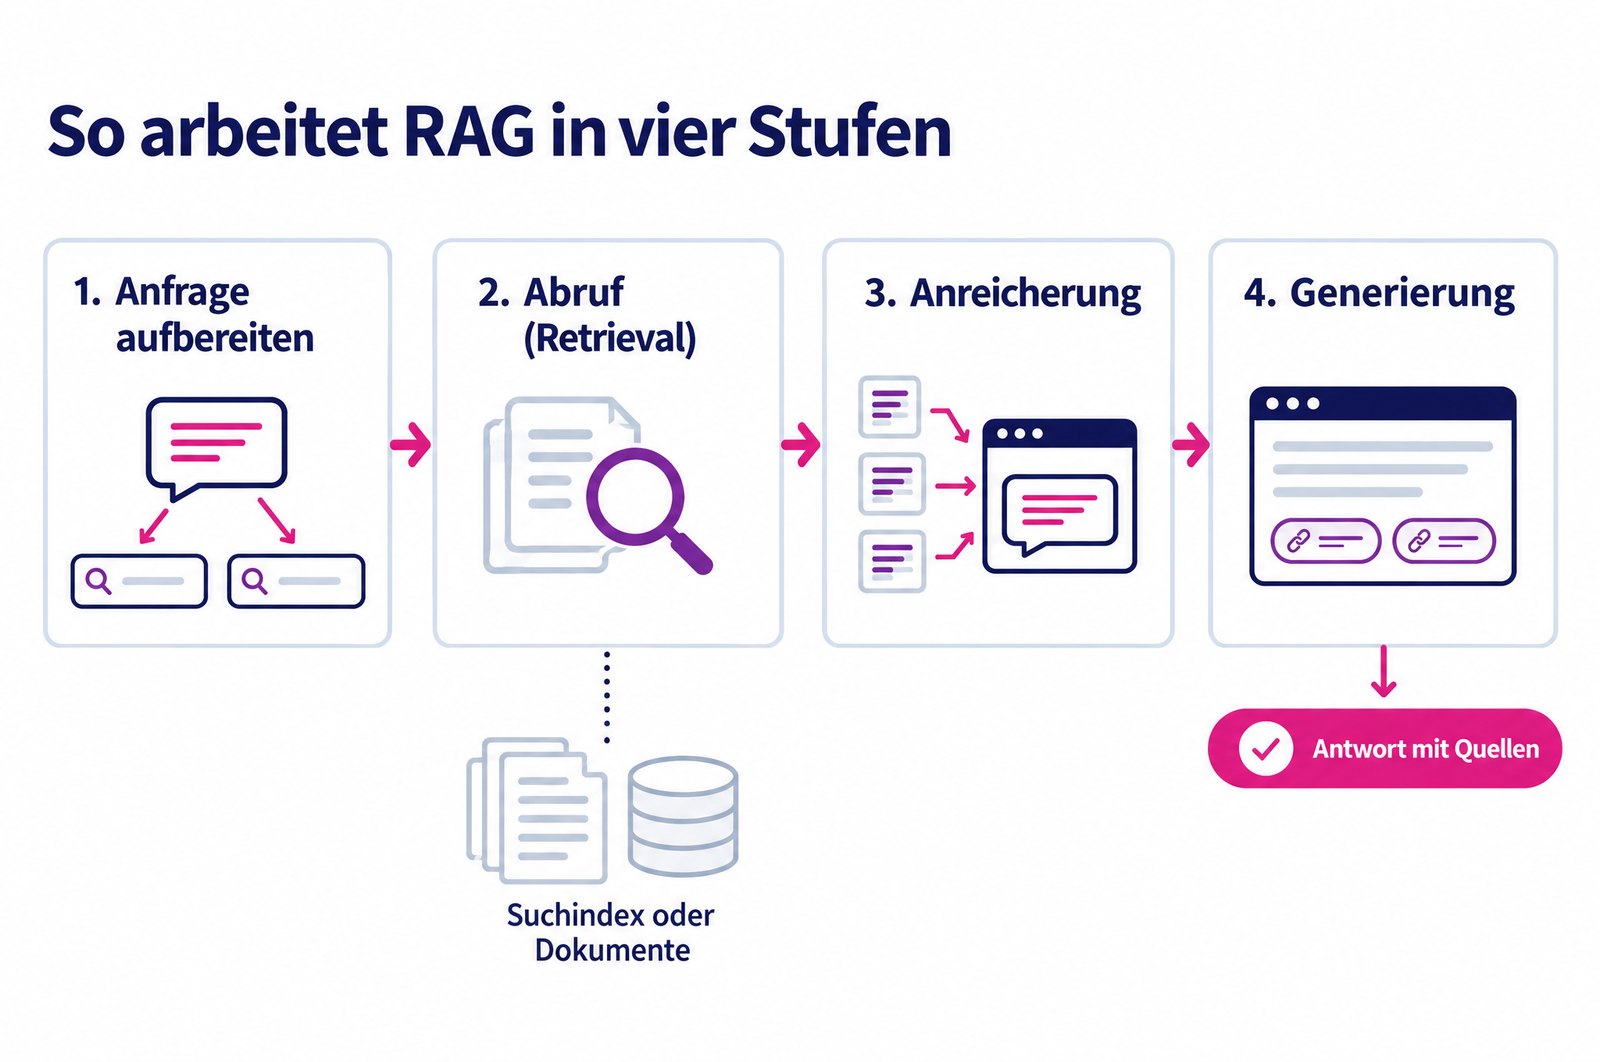
Ein LLM allein antwortet aus seinem Gedächtnis. Dieses Wissen endet mit dem Training und enthält über einen mittelständischen Zulieferer oft nur wenige, teils veraltete Angaben. RAG schiebt vor die Antwort einen Suchschritt. Vereinfacht läuft das in vier Stufen ab:
| Stufe | Was passiert | Was Sie als Anbieter beeinflussen |
|---|---|---|
| 1. Anfrage aufbereiten | Das System formuliert den Prompt in eine oder mehrere Suchanfragen um | Nichts direkt, aber Ihre Seiten sollten die Begriffe und Fragen Ihrer Kunden abdecken |
| 2. Abruf (Retrieval) | Ein Suchsystem holt passende Seiten oder Passagen aus einem Index | Crawlbarkeit, Indexierung, Ranking für die Teilfragen |
| 3. Anreicherung (Augmentation) | Die besten Passagen werden zusammen mit der Frage an das Modell übergeben | Klare, in sich verständliche Abschnitte mit konkreten Fakten |
| 4. Generierung | Das Modell formuliert die Antwort und verknüpft Aussagen mit Quellen | Nur indirekt, über einheitliche und belegbare Angaben in allen Quellen |
Im Abrufschritt arbeiten je nach System klassische Stichwortsuche, semantische Suche über sogenannte Embeddings oder eine Kombination aus beidem. Häufig sortiert ein zweites Verfahren die Treffer noch einmal fein, bevor sie an das Modell gehen, denn das Kontextfenster des Modells fasst nur eine begrenzte Textmenge. Diese Bausteine erklären wir in eigenen Glossar-Einträgen.
Wo Ihnen RAG begegnet
In der KI-Suche. Google beschreibt die Technik in seinem Leitfaden zur KI-Suche vom Mai 2026 ausdrücklich: Retrieval-Augmented Generation, auch Grounding genannt, nutzt die Kern-Ranking-Systeme der Suche, um relevante und aktuelle Seiten aus dem Google-Index abzurufen. Aus diesen Seiten formulieren die Systeme die Antwort und zeigen anklickbare Links zu den Quellen. ChatGPT formuliert laut OpenAI-Hilfe die Frage eines Nutzers in eine oder mehrere gezielte Suchanfragen um und schickt sie teils an Suchpartner. Damit eine Website überhaupt in Frage kommt, muss sie den Crawler OAI-SearchBot zulassen. Wie Sie KI-Crawler einordnen, beschreibt unser Ratgeber zu KI-Crawlern und robots.txt.
In eigenen Anwendungen. Derselbe Mechanismus steckt in Firmen-Chatbots und Wissensassistenten. Statt des Webindex durchsucht das System dann Ihre Handbücher, Datenblätter, Normen-Zusammenfassungen oder Servicetickets. Das Sprachmodell bleibt unverändert, es bekommt bei jeder Frage die passenden Auszüge mitgeliefert.
RAG und verwandte Begriffe
Rund um RAG kursieren viele Fachbegriffe, die oft vermischt werden. Die folgende Übersicht ordnet sie ein:
| Begriff | Was es ist | Verhältnis zu RAG |
|---|---|---|
| Parametrisches Wissen | Das im Training gelernte Wissen in den Modellgewichten | Das, was RAG ergänzt und aktualisiert |
| Fine-Tuning | Nachtraining eines Modells mit eigenen Beispielen | Alternative oder Ergänzung, verändert das Modell selbst |
| Grounding | Verankern einer Antwort in überprüfbaren Quellen | Das Ziel; RAG ist die verbreitetste Technik dafür |
| Embedding | Zahlenvektor, der die Bedeutung eines Textes abbildet | Baustein des semantischen Abrufs |
| Vektordatenbank | Speicher für Embeddings mit schneller Ähnlichkeitssuche | Infrastruktur für den Abruf |
| Chunking | Zerlegen von Dokumenten in Passagen | Vorbereitung des Bestands, nicht Aufgabe des Website-Betreibers |
| Reranking | Feinsortierung der abgerufenen Treffer | Auswahlschritt zwischen Abruf und Antwort |
Für eigene Projekte ist vor allem die Frage RAG oder Fine-Tuning relevant. Faustregel: Soll das Modell etwas wissen, das sich ändert, etwa Lieferprogramm, Preise oder Revisionsstände von Anleitungen, ist RAG die naheliegende Wahl, weil ein aktualisiertes Dokument sofort wirkt. Soll das Modell dagegen einen bestimmten Stil oder ein festes Ausgabeformat lernen, etwa die Struktur Ihrer Prüfberichte, kann Fine-Tuning sinnvoll sein. Viele Anwendungen kombinieren beides.
Wichtig ist außerdem die Unterscheidung zwischen Verfahren und Produkt. RAG ist kein Werkzeug, das man kauft, sondern ein Bauprinzip. Wer von einem Anbieter hört, sein Chatbot arbeite „mit RAG“, sollte nachfragen, welche Quellen abgerufen werden, wie aktuell sie sind und ob die Antwort die Quellen ausweist.
Was RAG für Ihre KI-Sichtbarkeit bedeutet
Aus dem Ablauf folgen vier praktische Konsequenzen.
Erstens: Was im Abrufschritt nicht gefunden wird, existiert für die Antwort nicht. Eine Seite muss erreichbar, indexiert und für Snippets zulässig sein. Google nennt genau diese Voraussetzungen im Leitfaden.
Zweitens: Der Abruf ist Suche. In unserer Studie zur KI-Sichtbarkeit von 41 Industriefirmen standen nur 2 Unternehmen für den naheliegenden Begriff ihrer Kernleistung in den Google-Top-10. Die mindestens einmal genannten Firmen waren bei Google im Median rund zehnmal sichtbarer als die nie genannten. Das ist ein Zusammenhang, kein Beweis, passt aber zur Logik von RAG.
Drittens: Die Quelle muss nicht Ihre Website sein. Perplexity stützte sich in unserer Studie in 80 von 82 Antworten auf mindestens ein B2B-Verzeichnis. Ein gepflegtes Profil bei wer liefert was wird also ebenfalls abgerufen.
Viertens: Die Information muss als Text vorliegen. Druckstufen, Werkstoffe oder Zertifikate, die nur in einem eingescannten Katalog stehen, lassen sich schlecht abrufen und noch schlechter zitieren. In Häppchen zerlegen müssen Sie Ihre Seiten dafür nicht, das hat Google ausdrücklich klargestellt.
RAG in der Industrie-Praxis
Ein Beispiel, wie es typisch abläuft: Ein Einkäufer fragt eine KI-Suche nach Herstellern von Dosierpumpen, die für 50-prozentige Natronlauge geeignet sind. Das System zerlegt die Frage in Teilsuchen nach Herstellern, Werkstoffbeständigkeit und Bauarten und ruft dazu Seiten ab. Ein Hersteller hat seine Beständigkeitstabelle nur als Bild in einem Katalog-PDF, seine Produktseite nennt „für aggressive Medien geeignet“. Ein Wettbewerber führt auf der Produktseite Werkstoffkombinationen, Temperaturgrenzen und Konzentrationsbereiche als Text. Im Abrufschritt passt die zweite Seite deutlich besser zur Teilfrage, und nur sie liefert eine Passage, auf die sich eine Aussage stützen lässt. Genannt wird der Wettbewerber, obwohl beide Pumpen technisch gleichwertig sein mögen.
Dasselbe Unternehmen kann RAG intern nutzen. Ein Servicetechniker fragt einen Assistenten nach dem Anzugsmoment einer Membranschraube für eine bestimmte Baureihe. Das System durchsucht die Wartungsanleitungen, findet den passenden Abschnitt und nennt den Wert mit Verweis auf Dokument und Seite. Der Techniker kann die Angabe prüfen, statt einem Modell blind zu vertrauen. Wie solche Assistenten aufgebaut und abgesichert werden, zeigt unsere Seite zum KI-Chatbot für Industrieunternehmen.
Häufige Fehler
Drei Missverständnisse begegnen uns regelmäßig. Das erste: RAG mache Fehler unmöglich. Abgerufene Quellen können veraltet oder widersprüchlich sein, und das Modell kann sie falsch zusammenfassen. OpenAI weist selbst darauf hin, dass Suchergebnisse und Quellenangaben unvollständig oder falsch sein können. Warum gerade Mittelständler betroffen sind, beschreibt unser Ratgeber zu KI-Halluzinationen.
Das zweite: Für RAG brauche man eine Sonderdatei oder ein Spezialformat. Für die Google-Suche gilt das laut Google nicht, auch eine llms.txt wird dort ignoriert. Entscheidend sind indexierbare Seiten mit eigener fachlicher Substanz.
Das dritte: Man könne die Wirkung nicht messen. Ob Ihr Unternehmen in den Antworten auftaucht, lässt sich mit einem festen Fragenset beobachten. Diese Methode heißt Prompt-Tracking, die Kennzahl dazu ist die Nennungsrate. Wer verstehen will, warum Abruf und klassisches Ranking so eng zusammenhängen, findet die Einordnung im Eintrag zur Generative Engine Optimization. Wie wir Inhalte und Quellen gezielt so aufbauen, dass KI-Systeme sie im Abrufschritt finden, beschreibt unsere Leistung GEO und KI-Sichtbarkeit.
Quellen
- Lewis, P. et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv, Mai 2020, NeurIPS 2020
- Google Search Central: Optimizing your website for generative AI features on Google Search, Leitfaden vom 15.05.2026, Stand der Seite 10.07.2026
- OpenAI Help Center: Searching the web with ChatGPT, abgerufen am 15.10.2026
- Eigene Studie vertriebsmitarbeiter.ai: KI-Sichtbarkeit von 41 Industriefirmen, Messung vom 14.10.2026
Häufige Fragen zu RAG (Retrieval-Augmented Generation)
Was ist RAG (Retrieval-Augmented Generation)?
RAG ist ein Verfahren, bei dem ein Sprachmodell vor dem Antworten passende Textpassagen aus einer externen Quelle abruft, etwa aus einem Suchindex oder einer Dokumentensammlung. Die Antwort stützt sich dann auf diese Passagen statt nur auf das gelernte Wissen. Dadurch werden Antworten aktueller, überprüfbar und können mit Quellenangaben versehen werden.
Nutzt Google RAG für AI Overviews und AI Mode?
Ja. Google nennt Retrieval-Augmented Generation in seinem Leitfaden zur KI-Suche ausdrücklich, auch unter dem Begriff Grounding. Die Kern-Ranking-Systeme der Suche rufen relevante, aktuelle Seiten aus dem Index ab, die KI formuliert daraus die Antwort und verlinkt unterstützende Quellen. Deshalb gelten für die KI-Funktionen laut Google dieselben Grundlagen wie für die normale Suche.
Was bedeutet RAG für die Sichtbarkeit meines Unternehmens?
Eine KI-Suche kann nur verwenden, was sie im Abrufschritt findet. Ihre Seiten müssen also crawlbar, indexiert und für die Fragen Ihrer Kunden auffindbar sein. Entscheidend ist außerdem, dass die gesuchte Information als Text auf der Seite steht, klar formuliert und belegbar, und nicht nur in Bildern, Scans oder hinter Formularen.
Was ist der Unterschied zwischen RAG und Fine-Tuning?
Beim Fine-Tuning wird ein Modell mit zusätzlichen Beispielen nachtrainiert, das Wissen landet dauerhaft in den Modellgewichten. Bei RAG bleibt das Modell unverändert, es bekommt die passenden Dokumente erst im Moment der Anfrage mitgeliefert. Für wechselndes Firmenwissen wie Datenblätter, Preislisten oder Handbücher ist RAG meist die einfachere und besser kontrollierbare Wahl.
Brauche ich eine llms.txt oder ein spezielles Format, damit RAG meine Inhalte findet?
Für die Google-Suche nicht. Google schreibt im Leitfaden zur KI-Suche, dass die Suche llms.txt und ähnliche Dateien ignoriert und auch keine Zerlegung der Inhalte in kleine Häppchen nötig ist. Wichtiger sind gut gegliederte, indexierbare Seiten mit eigener fachlicher Substanz. Andere Systeme können solche Dateien nutzen, eine Wirkung auf die Nennung ist bisher nicht belegt.
Diesen Begriff in Ergebnisse übersetzen? Das übernehmen wir im Bereich GEO / KI-Sichtbarkeit.