
Kontextfenster (Context Window)
Das Kontextfenster begrenzt, wie viel Text ein KI-Modell pro Anfrage verarbeitet. Größen, Grenzen, eigene Token-Messung für Deutsch und Folgen für die Praxis.
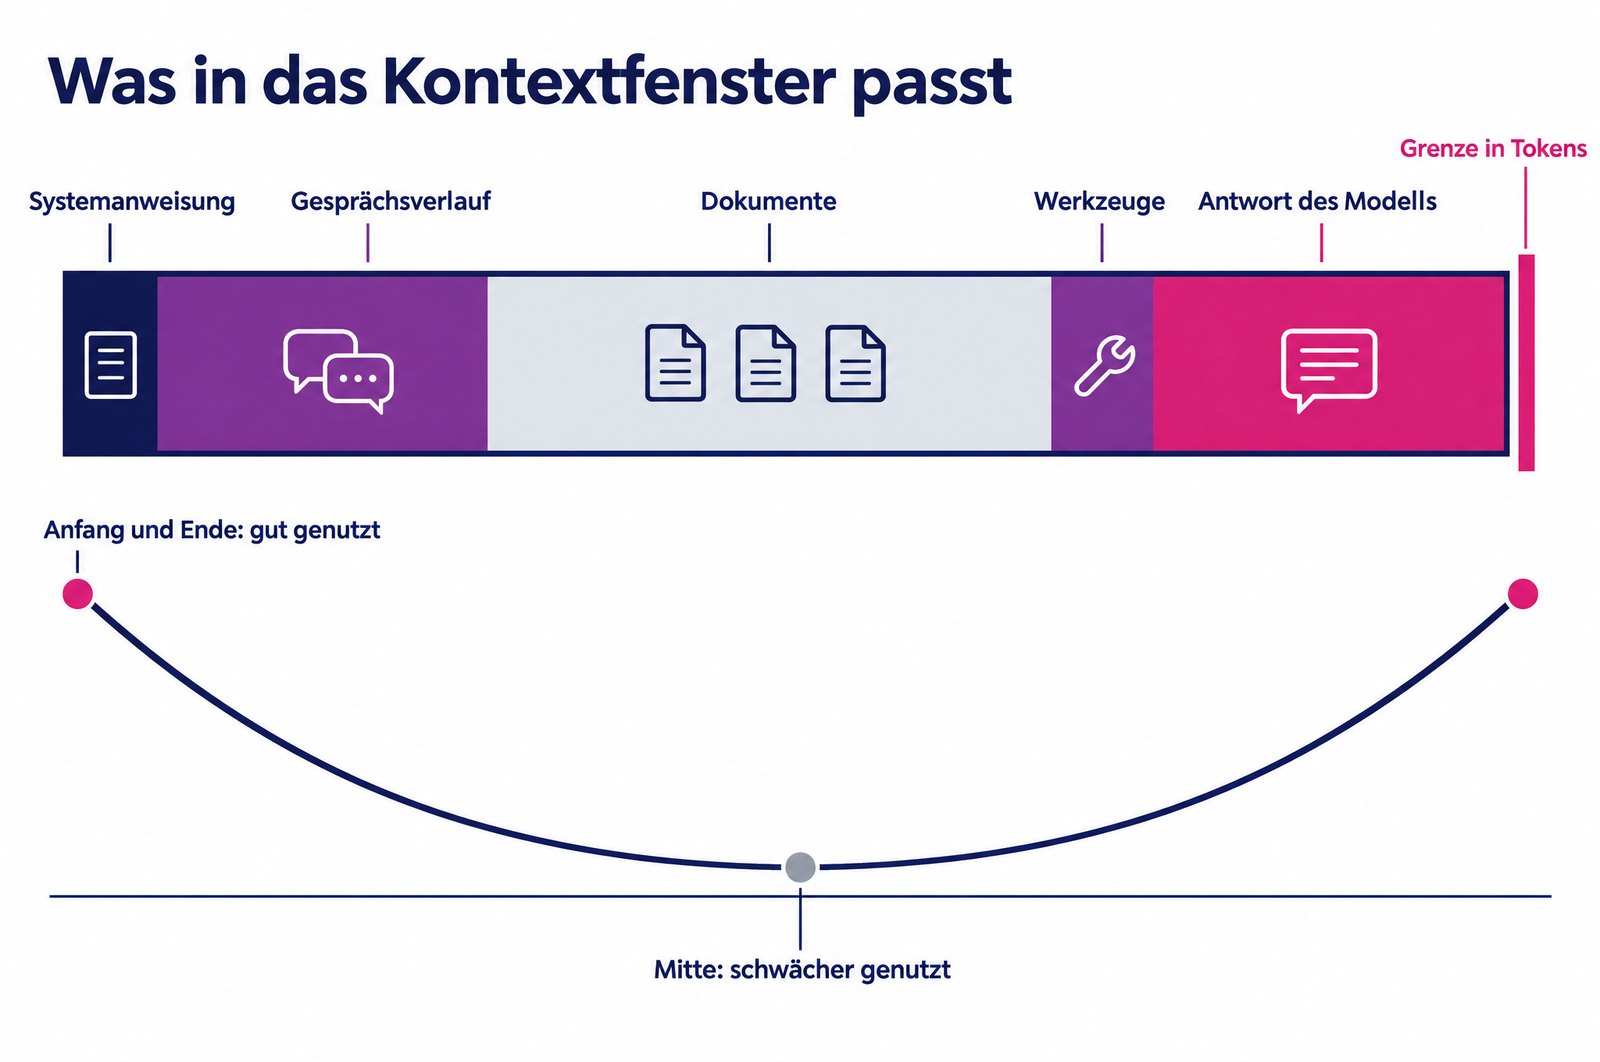
Das Kontextfenster (englisch Context Window) ist die maximale Textmenge, gemessen in Tokens, die ein Sprachmodell bei einer einzelnen Anfrage berücksichtigen kann. Dazu zählen Systemanweisung, bisheriger Gesprächsverlauf, beigefügte Dokumente, Werkzeugbeschreibungen und die Antwort des Modells selbst.
Anthropic beschreibt das Kontextfenster in seiner Dokumentation als Arbeitsgedächtnis des Modells, das vom Trainingswissen zu unterscheiden ist. Was weder im Kontextfenster steht noch im Training gelernt wurde, kann ein Modell bei der Antwort nicht berücksichtigen. Für Unternehmen, die KI mit eigenen Dokumenten nutzen, ist das Kontextfenster deshalb eine der wichtigsten technischen Randbedingungen.
Wie das Kontextfenster funktioniert
Ein großes Sprachmodell verarbeitet Text nicht in Wörtern, sondern in Tokens, also in Wortteilen, ganzen Wörtern oder Satzzeichen. Bei jeder Anfrage wird der gesamte relevante Text in Tokens zerlegt und dem Modell übergeben. Im Chat bedeutet das: Mit jeder Nachricht wächst der Verlauf, der bei der nächsten Anfrage erneut mitgeschickt wird. Ist die Grenze erreicht, muss etwas weichen. Programmierschnittstellen lehnen zu lange Eingaben ab, Chat-Oberflächen kürzen oder fassen ältere Teile zusammen.
Die Größe hat in den vergangenen Jahren stark zugenommen. Anthropic nennt für seine aktuellen Claude-Modelle ein Kontextfenster von bis zu einer Million Tokens, Google gibt für Gemini-Modelle eine Million Tokens oder mehr an (Stand Oktober 2026, jeweilige Herstellerdokumentation). Wichtig für die Planung: Auch die Ausgabe zählt mit, bei Modellen mit Denkphase einschließlich der internen Denk-Tokens. Und der Umfang hat Folgen für Kosten und Tempo: Bei Programmierschnittstellen wird in der Regel nach verarbeiteten Tokens abgerechnet, und weil der Verlauf mit jeder Anfrage erneut übergeben wird, werden lange Gespräche mit jedem Schritt teurer und langsamer. Wer einen Assistenten in einen Ablauf mit Hunderten Anfragen am Tag einbaut, sollte deshalb früh festlegen, welcher Kontext wirklich gebraucht wird.
Wie viel Text in ein Kontextfenster passt, hängt von der Sprache ab. Wir haben eigene Seiten mit dem Tokenizer o200k_base gezählt, den OpenAI unter anderem für GPT-4o und neuere Modelle verwendet:
| Inhalt | Wörter | Tokens | Tokens pro Wort |
|---|---|---|---|
| Glossarartikel „Nennungsrate“ | 1.292 | 2.288 | 1,8 |
| Studie KI-Sichtbarkeit Industrie 2026 | 1.980 | 3.829 | 1,9 |
| Faustregel von OpenAI für englischen Text | 75 | 100 | 1,3 |
Die Messung stammt vom 15.10.2026 und zählt die Markdown-Auszeichnung mit, die Faustregel stammt aus der OpenAI-Hilfe. Hochgerechnet entspricht eine Million Tokens grob 550.000 deutschen Wörtern. Das ist eine Schätzung, denn andere Modelle zerlegen Text anders.
Größer ist nicht automatisch besser
Ein großes Kontextfenster heißt nicht, dass das Modell alles darin gleich gut nutzt. Anthropic schreibt in seiner Dokumentation ausdrücklich, dass mehr Kontext nicht automatisch besser ist: Mit wachsender Tokenzahl sinken Genauigkeit und Erinnerungsleistung, ein Effekt, den Anthropic als Context Rot bezeichnet. Die Studie „Lost in the Middle“ von Liu und anderen (2023) zeigte, dass Sprachmodelle Informationen am Anfang und am Ende eines langen Kontexts besser nutzen als Informationen in der Mitte. Auch Google räumt in seiner Dokumentation zu langen Kontexten ein, dass die Genauigkeit sinkt, wenn mehrere einzelne Informationen in einem langen Text gesucht werden.
Für die Praxis folgt daraus: Gezielt ausgewählter Kontext schlägt maximalen Kontext. Wer einem Modell ein 200-seitiges Dokument und eine Frage gibt, bekommt eher eine lückenhafte Antwort als jemand, der die drei relevanten Kapitel auswählt. Genau diese Auswahl ist der Kern dessen, was unter Prompt Engineering und Context Engineering verstanden wird.
Abgrenzung: Kontextfenster, Trainingswissen und RAG
| Begriff | Was es ist | Beispiel |
|---|---|---|
| Trainingswissen | im Modell gespeicherte Muster bis zum Trainingsstichtag | allgemeines Wissen über Werkstoffe |
| Kontextfenster | Text, den das Modell bei einer Anfrage sieht | das Lastenheft, das Sie hochladen |
| RAG | Verfahren, das passende Passagen sucht und ins Kontextfenster legt | Suche im Archiv aller Datenblätter |
| Gedächtnisfunktion | gespeicherte Notizen, die in spätere Anfragen eingefügt werden | Vorlieben eines Nutzers im Chat-Assistenten |
Das Kontextfenster ist damit die Schnittstelle, über die aktuelles oder internes Wissen zum Modell gelangt. RAG löst das Problem, dass ganze Wissensbestände nicht hineinpassen oder nicht sinnvoll hineingehören: Statt alles mitzugeben, wird nur das Passende abgerufen. Auch Gedächtnisfunktionen von Chat-Assistenten arbeiten in der Regel so, dass gespeicherte Informationen bei Bedarf wieder in das Kontextfenster eingefügt werden. Ein Modell erinnert sich zwischen zwei getrennten Sitzungen nicht von selbst.
Kontextfenster in der Industrie-Praxis
Beispiel: Ein Anlagenbauer erhält als RFQ eines Getränkeherstellers ein Lastenheft mit 180 Seiten für eine Abfüllanlage. Der Vertriebsingenieur lädt das komplette Dokument in einen KI-Assistenten und fragt, welche Anforderungen vom Standardangebot abweichen. Das Dokument passt problemlos ins Kontextfenster, die Antwort wirkt vollständig. Bei der Kontrolle fällt jedoch auf, dass eine Anforderung zur Reinigbarkeit aus Kapitel 7, mitten im Dokument, fehlt.
Das Team ändert daraufhin das Vorgehen. Das Lastenheft wird kapitelweise geprüft, jede Anfrage enthält das jeweilige Kapitel, die Checkliste der eigenen Standardausführung und die Anweisung, jede Abweichung mit Kapitelnummer zu belegen. Abweichungen ohne Fundstelle gelten als ungeprüft. Der Aufwand steigt leicht, dafür lässt sich jede Aussage am Original nachprüfen. Die finale Abweichungsliste prüft weiterhin ein Mensch, bevor sie in das Angebot einfließt. Aus dem Fall leitet das Team eine einfache Regel ab: Je wichtiger die Vollständigkeit, desto kleiner die Portionen und desto strenger die Pflicht zur Quellenangabe.
Was das Kontextfenster für KI-Suche und GEO bedeutet
KI-Suchsysteme wie ChatGPT mit Websuche, Perplexity oder Google AI Mode laden in der Regel nicht ganze Websites in das Kontextfenster, sondern rufen passende Seiten oder Passagen ab und stützen die Antwort darauf. Für Ihre Inhalte heißt das: Ein Abschnitt, der eine Frage für sich verständlich beantwortet, mit klarer Überschrift, konkreten Zahlen und eindeutigen Begriffen, lässt sich leichter herauslösen und zitieren als eine Aussage, die nur im Zusammenhang der ganzen Seite verständlich ist.
Zugleich gilt Googles Hinweis aus dem Leitfaden zur KI-Suche vom Mai 2026: Inhalte müssen nicht künstlich in kleine Häppchen zerlegt werden, Google versteht auch Seiten mit mehreren Themen. Gute Struktur ist also kein Sonderformat für KI, sondern dieselbe Lesbarkeit, die auch Menschen hilft. Wie Generative Engine Optimization darauf aufbaut, beschreibt der Ratgeber GEO vs. SEO.
Häufige Fehler
Erstens werden ganze Ordner in einen Assistenten geladen, im Vertrauen auf das große Kontextfenster. Zweitens nehmen viele an, das Modell habe frühere Sitzungen im Gedächtnis. Drittens wird vergessen, dass die Antwort selbst Platz braucht, besonders bei Modellen mit langer Denkphase. Viertens laufen lange Chatverläufe weiter, in denen veraltete Zwischenstände stehen; ein neuer Chat mit sauber ausgewähltem Kontext liefert oft bessere Ergebnisse. Fünftens landen vertrauliche Dokumente in Werkzeugen, deren Datenverarbeitung nicht vertraglich geklärt ist.
Wie sich Sprachmodelle mit ausgewähltem Kontext verlässlich in Abläufe einbinden lassen, etwa als Assistent mit Zugriff auf Ihre Dokumentation, zeigt unsere Leistung KI-Automatisierung. Konkrete Einsatzfelder im Vertrieb beschreibt die Seite KI-Agenten.
Quellen
- Anthropic: Context windows, abgerufen am 15.10.2026
- Google AI for Developers: Long context, Stand 13.10.2026
- Liu, N. F. u. a.: Lost in the Middle: How Language Models Use Long Contexts, arXiv, 06.07.2023
- OpenAI Help Center: Understanding and counting tokens, abgerufen am 15.10.2026
- Google Search Central: Leitfaden zur Optimierung für KI-Funktionen der Google-Suche, veröffentlicht am 15.05.2026
- Eigene Messung vertriebsmitarbeiter.ai vom 15.10.2026 mit dem Tokenizer o200k_base aus OpenAIs Open-Source-Bibliothek tiktoken
Häufige Fragen zu Kontextfenster (Context Window)
Was ist ein Kontextfenster bei KI?
Das Kontextfenster ist die maximale Textmenge, die ein Sprachmodell bei einer einzelnen Anfrage berücksichtigen kann. Gemessen wird sie in Tokens, also Wortteilen und Zeichen. Dazu zählen Systemanweisung, bisheriger Gesprächsverlauf, hochgeladene Dokumente und die Antwort selbst. Was weder im Kontextfenster steht noch im Training gelernt wurde, kann das Modell nicht berücksichtigen.
Wie groß ist das Kontextfenster aktueller KI-Modelle?
Das unterscheidet sich je nach Modell und Anbieter. Anthropic nennt für aktuelle Claude-Modelle bis zu eine Million Tokens, Google gibt für Gemini-Modelle eine Million Tokens oder mehr an (Stand Oktober 2026). Da sich diese Werte mit jeder Modellgeneration ändern, lohnt vor einem Projekt immer der Blick in die aktuelle Dokumentation des jeweiligen Anbieters.
Wie viele Wörter passen in ein Kontextfenster?
Für englischen Text nennt OpenAI als Faustregel rund 75 Wörter pro 100 Tokens. Deutsche Texte brauchen mehr Tokens, weil lange zusammengesetzte Wörter in mehrere Teile zerlegt werden. In unserer eigenen Messung kamen deutsche Fachseiten auf etwa 1,8 Tokens pro Wort. Eine Million Tokens entspricht damit grob 550.000 deutschen Wörtern, als Schätzung.
Was passiert, wenn das Kontextfenster voll ist?
Programmierschnittstellen lehnen zu lange Eingaben mit einer Fehlermeldung ab oder brechen die Antwort an der Grenze ab. Chat-Oberflächen kürzen oder fassen ältere Teile des Verlaufs zusammen, die dann nicht mehr vollständig berücksichtigt werden. Die Qualität kann aber schon vorher sinken, weil Modelle Informationen in sehr langen Texten weniger zuverlässig finden.
Ist ein größeres Kontextfenster immer besser?
Nein. Ein großes Kontextfenster erlaubt lange Dokumente, garantiert aber nicht, dass das Modell alles darin gleich gut nutzt. Anthropic beschreibt sinkende Genauigkeit bei wachsender Tokenzahl, Studien zeigen Schwächen bei Informationen in der Mitte langer Texte. Gezielt ausgewählter Kontext liefert deshalb oft bessere Ergebnisse als ein komplett hochgeladener Dokumentenordner.
Diesen Begriff in Ergebnisse übersetzen? Das übernehmen wir im Bereich KI-Automatisierung.