In unserer Studie zur KI-Sichtbarkeit von 41 Industrieunternehmen hat genau eine Website KI-Crawler per robots.txt ausgesperrt. Die Technik ist bei den meisten Herstellern und Zulieferern also nicht der Engpass. Trotzdem landet die Frage regelmäßig auf dem Tisch von IT-Leitung und Marketing: Sollen wir GPTBot sperren? Was ist mit ClaudeBot? Und verschwinden wir dann aus ChatGPT?
Die Antwort hängt davon ab, welchen Crawler Sie meinen. Die großen KI-Anbieter betreiben getrennte Kennungen für sehr verschiedene Aufgaben. Wer sie verwechselt, sperrt im ungünstigsten Fall genau den Bot, der das eigene Unternehmen in KI-Antworten sichtbar macht, und lässt den durch, den er eigentlich fernhalten wollte. Dieser Artikel ordnet die wichtigsten Kennungen nach der offiziellen Dokumentation der Anbieter ein, Stand Oktober 2026, und zeigt, wie eine robots.txt für ein Industrieunternehmen aussehen kann.
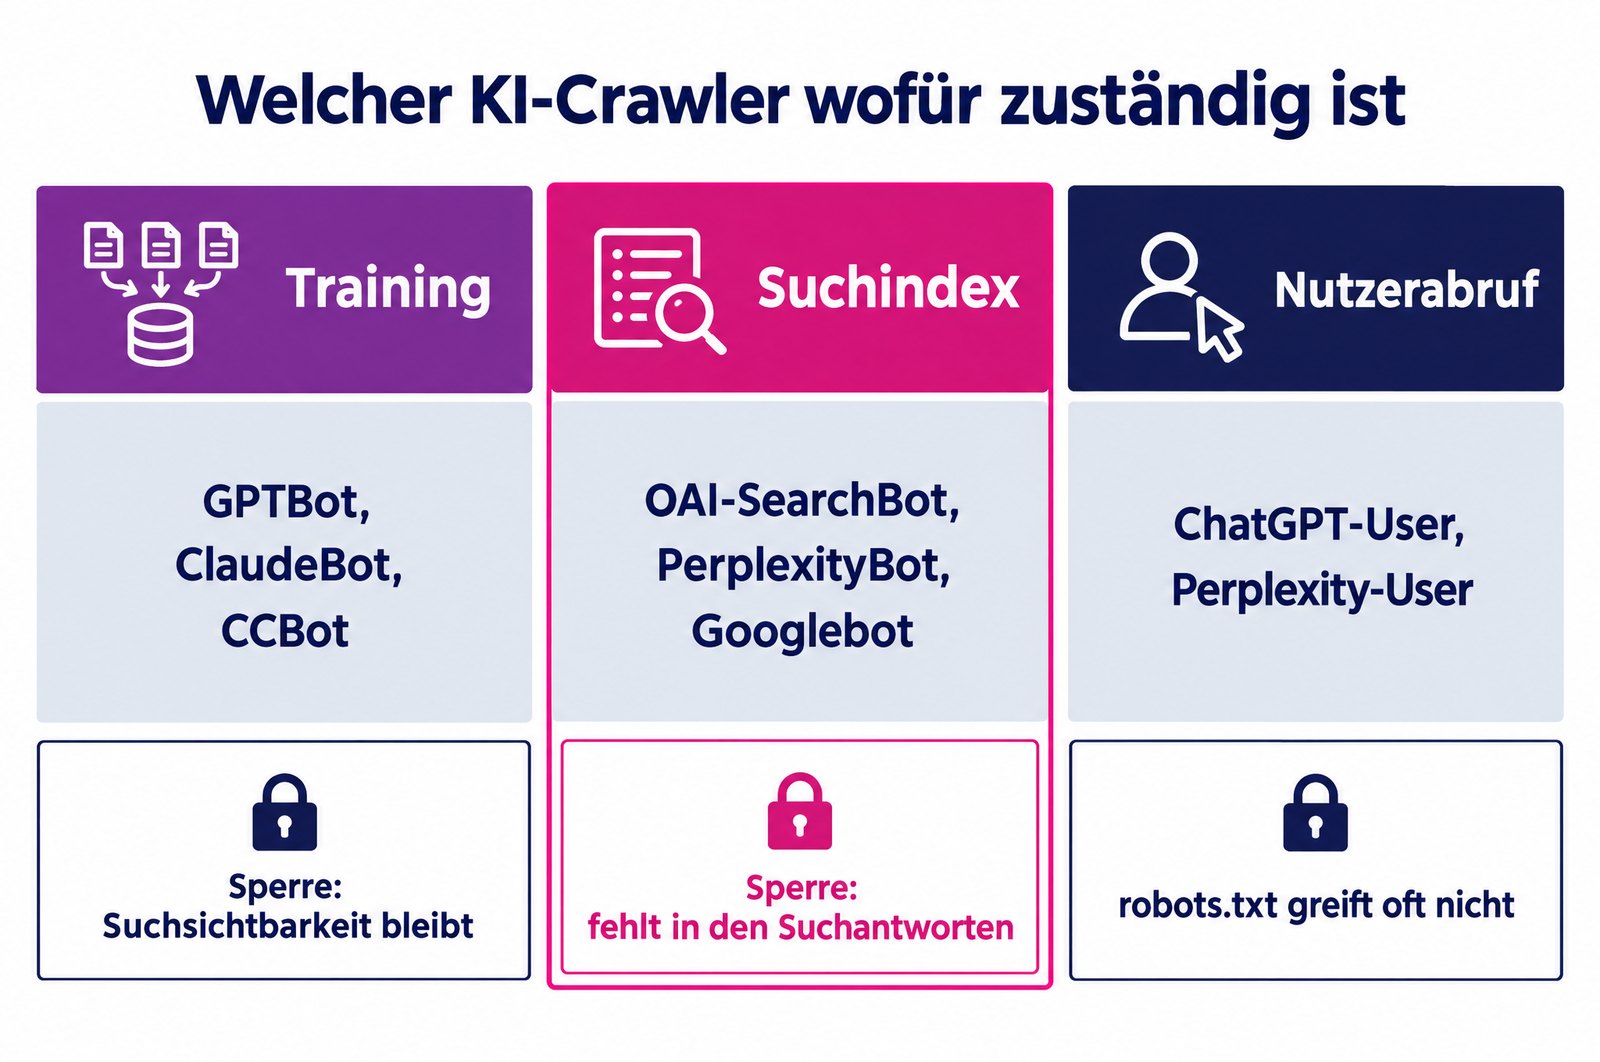
Training, Suchindex, Nutzerabruf: drei verschiedene Aufgaben
Bevor es um einzelne Namen geht, hilft eine Unterscheidung, die sich bei OpenAI, Anthropic und Perplexity gleichermaßen findet.
Trainings-Crawler sammeln Inhalte, die in das Training künftiger Sprachmodelle einfließen können. Wer sie sperrt, signalisiert: Meine Inhalte sollen nicht in Trainingsdaten landen. Ob eine Website in einer KI-Suche als Quelle erscheint, hängt laut den Anbietern nicht an diesen Kennungen.
Such-Crawler bauen den Index auf, aus dem ChatGPT, Claude oder Perplexity bei einer Websuche ihre Quellen ziehen. Sie sind das Gegenstück zum Googlebot. Wer sie sperrt, fällt weitgehend aus den Antworten dieser Suchfunktionen heraus.
Nutzergesteuerte Abrufe entstehen, wenn ein Mensch einem Assistenten eine konkrete Seite zu lesen gibt oder der Assistent während einer Unterhaltung eine Seite öffnet. Das ist kein Crawling im klassischen Sinn. Mehrere Anbieter erklären deshalb, dass die robots.txt hier nicht oder nur eingeschränkt greift. Dasselbe gilt für KI-Agenten, die im Auftrag eines Nutzers Websites bedienen, wie wir im Artikel über KI-Browser und Agenten beschreiben.
Für ein Industrieunternehmen ist diese Dreiteilung die eigentliche Entscheidungsgrundlage. Wer in den Antworten auftauchen will, die ein technischer Einkäufer bei der Lieferantensuche liest, braucht die Such-Crawler. Ob er zusätzlich Trainingsdaten liefert, ist eine eigene Frage.
Die wichtigsten KI-Crawler im Überblick
Die Tabelle fasst zusammen, was die Anbieter selbst zu ihren Kennungen schreiben. Die Kennung ist der Name, den Sie in der robots.txt hinter „User-agent:“ eintragen.
| Anbieter | Kennung | Aufgabe laut Anbieter | Beachtet robots.txt | Folge einer Sperre |
|---|---|---|---|---|
| OpenAI | GPTBot | Inhalte für das Training der Basismodelle | ja | Inhalte sollen nicht ins Training |
| OpenAI | OAI-SearchBot | Websites in den Suchfunktionen von ChatGPT anzeigen | ja | keine Anzeige in ChatGPT-Suchantworten, höchstens als Navigationslink |
| OpenAI | ChatGPT-User | Abrufe bei Nutzeraktionen in ChatGPT und Custom GPTs | nicht unbedingt | kaum steuerbar |
| Anthropic | ClaudeBot | Webinhalte für die Entwicklung der Modelle sammeln | ja | künftige Inhalte sollen nicht ins Training |
| Anthropic | Claude-SearchBot | Qualität der Suchergebnisse für Nutzer verbessern | ja | geringere Sichtbarkeit in Claude-Suchergebnissen |
| Anthropic | Claude-User | Abruf, wenn Nutzer Claude eine Frage stellen | ja | Seite wird bei Nutzerfragen nicht abgerufen |
| Perplexity | PerplexityBot | Websites in Perplexity-Ergebnissen anzeigen und verlinken, kein Training | ja | keine Anzeige in Perplexity-Ergebnissen |
| Perplexity | Perplexity-User | Abruf bei Nutzerfragen | in der Regel nicht | kaum steuerbar |
| Googlebot | Google-Suche einschließlich AI Overviews und AI Mode | ja | Seite fällt aus der Google-Suche | |
| Google-Extended | kein eigener Crawler, Steuerzeichen für Gemini-Training und Grounding | ja | Suche bleibt unberührt | |
| Apple | Applebot-Extended | kein eigener Crawler, Steuerzeichen für das Training von Apple-Modellen | ja | Seiten bleiben in Apples Suche |
| Common Crawl | CCBot | offenes Web-Archiv, für Dritte frei nutzbar | ja | Seiten fehlen im Archiv |
OpenAI: GPTBot ist nicht die ChatGPT-Suche
OpenAI dokumentiert ausdrücklich, dass jede Kennung unabhängig steuerbar ist. Sie können also GPTBot sperren und OAI-SearchBot zulassen. Dann sollen Ihre Inhalte nicht ins Modelltraining fließen, Ihre Seiten können aber weiterhin als Quelle in ChatGPT-Suchantworten erscheinen. Umgekehrt gilt: Wer OAI-SearchBot aussperrt, wird laut OpenAI nicht mehr in Suchantworten gezeigt und taucht höchstens noch als Navigationslink auf. Änderungen an der robots.txt brauchen nach OpenAIs Angaben rund 24 Stunden, bis die Systeme sie berücksichtigen.
ChatGPT-User ist kein Crawler im eigentlichen Sinn. OpenAI schreibt, dass diese Kennung nicht für automatisches Crawling und nicht für die Entscheidung genutzt wird, ob Inhalte in der Suche erscheinen. Weil die Abrufe von Nutzern ausgelöst werden, gelten die robots.txt-Regeln hier möglicherweise nicht. Daneben führt OpenAI OAI-AdsBot, der nur Seiten prüft, die als Anzeige in ChatGPT eingereicht wurden.
Anthropic: drei Kennungen, alle an die robots.txt gebunden
Anthropic nennt ClaudeBot für das Sammeln von Trainingsdaten, Claude-SearchBot für den Suchindex und Claude-User für Abrufe auf Nutzerwunsch. Anders als OpenAI und Perplexity gibt Anthropic an, dass alle drei die robots.txt beachten, auch der nutzergesteuerte Abruf. Wer Claude-User sperrt, verringert laut Anthropic die eigene Sichtbarkeit bei nutzergesteuerten Suchen. Anthropic unterstützt außerdem die nicht standardisierte Angabe Crawl-delay und rät davon ab, die Bots über IP-Adressen zu blockieren, weil sie dann die robots.txt nicht mehr lesen können.
Perplexity: Suchindex ohne Training
PerplexityBot dient laut Perplexity dazu, Websites in den Suchergebnissen anzuzeigen und zu verlinken. Für das Training von KI-Basismodellen wird er nach Angaben des Anbieters nicht eingesetzt. Perplexity-User ruft Seiten ab, wenn Nutzer eine Frage stellen, und ignoriert die robots.txt in der Regel, weil der Abruf vom Nutzer angefordert wurde. Beide Kennungen haben veröffentlichte IP-Listen. Wie Perplexity seine Quellen auswählt, beschreibt unser Artikel Perplexity für Unternehmen.
Google: Der Googlebot ist auch die KI-Suche
Für AI Overviews und AI Mode gibt es keinen eigenen Crawler. Eine Seite muss laut Google indexiert und für ein Snippet zulässig sein, zusätzliche technische Anforderungen gibt es nicht. Wer den Googlebot sperrt, verliert deshalb die normale Suche und die KI-Funktionen zugleich. Was aus einer Seite in den KI-Funktionen gezeigt wird, steuern Sie mit nosnippet, data-nosnippet, max-snippet oder noindex, wie im Artikel zu AI Overviews beschrieben.
Google-Extended wird häufig missverstanden. Es hat keinen eigenen User-Agent, gecrawlt wird mit den bestehenden Google-Kennungen. Über Google-Extended legen Sie fest, ob Inhalte für das Training künftiger Gemini-Modelle und für das Grounding in Gemini-Apps und Vertex AI verwendet werden. Google stellt klar, dass Google-Extended die Aufnahme in die Google-Suche nicht beeinflusst und kein Rankingsignal ist. Zusätzlich führt Google nutzergesteuerte Abrufer, darunter Google-Agent für Agenten, die im Auftrag eines Nutzers im Web navigieren. Diese ignorieren die robots.txt laut Google in der Regel.
Apple, Common Crawl und Microsoft
Applebot-Extended funktioniert ähnlich wie Google-Extended: Er crawlt selbst nicht, sondern regelt, ob von Applebot erfasste Inhalte für das Training von Apples Modellen genutzt werden. Seiten mit einer Sperre können laut Apple weiterhin in den Suchergebnissen von Spotlight, Siri und Safari erscheinen. CCBot gehört zu Common Crawl, einer gemeinnützigen Stiftung, die ein offenes Archiv des Webs aufbaut. Weil dieses Archiv frei verfügbar ist, können Dritte es weiterverwenden, auch für eigene Modelle. Das ist unsere Einordnung, keine Angabe von Common Crawl.
Bei Microsoft läuft die Steuerung nicht über eine eigene KI-Kennung in der robots.txt, sondern über Meta-Angaben für den Bing-Index. Für die damalige Bing-Chat-Funktion, heute Copilot, hat Microsoft 2023 die Angaben NOCACHE und NOARCHIVE angekündigt: Mit NOARCHIVE sollen Inhalte nicht in Chat-Antworten erscheinen und nicht ins Training einfließen, in der Bing-Suche bleiben sie sichtbar. Prüfen Sie den aktuellen Stand in der Bing-Dokumentation, bevor Sie etwas umstellen.
Welche Einstellung zu welchem Ziel passt
Die folgende Übersicht übersetzt die Dokumentation in Entscheidungen. Sie ersetzt keine Abwägung im eigenen Haus, macht aber klar, welche Folgen eine Wahl hat.
| Ziel | Zulassen | Sperren | Was Sie wissen sollten |
|---|---|---|---|
| Größtmögliche Sichtbarkeit in KI-Antworten | alle Crawler | nichts | entspricht einer robots.txt ohne KI-Einträge |
| Sichtbar in KI-Suchen, kein Training | Googlebot, OAI-SearchBot, Claude-SearchBot, Claude-User, PerplexityBot | GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot | wirkt nur für künftige Abrufe |
| Einzelne Bereiche ausnehmen | alle Crawler | Verzeichnisse wie Kundenportal oder interne Suche | robots.txt ist kein Zugriffsschutz |
| Möglichst keine Nutzung durch KI-Anbieter | nur Googlebot und klassische Suchmaschinen | alle übrigen KI-Kennungen | Sichtbarkeit in KI-Suchen entfällt weitgehend, AI Overviews nutzen weiter den Google-Index, Nutzerabrufe bleiben teils möglich |
Für die meisten Hersteller und Zulieferer kommen die ersten beiden Varianten in Frage. Eine Industrie-Website beschreibt Produkte, Verfahren und Kompetenzen, sie soll gefunden werden. Ob die Teilnahme am Training einen Nutzen hat, lässt sich nicht messen. Unsere Einschätzung: Ein Modell, das ein Unternehmen aus Trainingsdaten kennt, kann es auch ohne Websuche nennen. In unserer Studie wurde ein international bekannter Komponentenhersteller in allen vier Antworten genannt, obwohl seine Website für den deutschen Kernbegriff nicht in den Top 30 stand. Die Marke war schlicht breit im Netz präsent. Ein Beweis für einen Trainingseffekt ist das nicht.
Gegen das Training sprechen nachvollziehbare Gründe: Fachartikel, Anwendungswissen und Konstruktionshinweise sind Arbeit, die ein Unternehmen nicht ungefragt in fremde Modelle geben möchte. Wichtig ist nur, dass diese Entscheidung bewusst fällt und nicht die Such-Crawler gleich mit aussperrt.
Beispiel: robots.txt für einen Fördertechnik-Hersteller
Das folgende Beispiel ist fiktiv. Ein Hersteller von Fördertechnik will in ChatGPT, Claude und Perplexity als Quelle erscheinen, möchte aber nicht, dass seine Inhalte ins Modelltraining fließen. Kundenportal und interne Suche sollen von keinem Crawler erfasst werden. Die Domain-Endung .example ist für Beispiele reserviert.
# robots.txt Beispielwerk Fördertechnik GmbH (fiktives Beispiel)

# Standardregeln für alle Crawler
User-agent: *
Disallow: /kundenportal/
Disallow: /suche/

# KI-Training: nicht erwünscht
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

# KI-Suche: erwünscht, interne Bereiche bleiben ausgenommen
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /kundenportal/
Disallow: /suche/

Sitemap: https://www.beispielwerk.example/sitemap.xml
Zwei Details entscheiden darüber, ob diese Datei tut, was sie soll. Erstens dürfen mehrere User-agent-Zeilen eine gemeinsame Gruppe bilden, das sieht der Standard ausdrücklich vor. Zweitens folgt ein Crawler, der eine Gruppe mit seinem eigenen Namen findet, nur dieser Gruppe und ignoriert die Standardregeln unter „User-agent: *“. Google beschreibt das so: Für einen Crawler gilt immer nur eine Gruppe, die mit der spezifischsten passenden Kennung. Deshalb stehen die Sperren für Kundenportal und Suche im dritten Block noch einmal. Ohne diesen Block würden die Such-Crawler einfach den Standardregeln folgen. Der Block ist also optional, macht die Absicht aber für jeden sichtbar, der die Datei später pflegt.
Sechs typische Fehler
- Eigene Gruppe hebelt die Standardregeln aus. Wer „User-agent: GPTBot“ mit „Allow: /“ einträgt, gibt diesem Bot auch die Bereiche frei, die unter „User-agent: *“ gesperrt sind.
- Die Sperre sitzt im CDN statt in der robots.txt. Firewalls und Bot-Schutzdienste können KI-Crawler blockieren, ohne dass die robots.txt davon etwas zeigt. Cloudflare fragt beispielsweise seit Juli 2025 bei neuen Domains, ob KI-Crawler zugelassen werden sollen, und bietet eine verwaltete robots.txt an, deren Einträge der eigenen Datei vorangestellt werden. Prüfen Sie deshalb die tatsächlich ausgelieferte Datei und die Einstellungen beim Hosting-Dienstleister.
- noindex hinter einer Crawl-Sperre. Ist eine Seite per robots.txt gesperrt, sieht Google das noindex nicht. Die Adresse kann über externe Links trotzdem im Index landen, dann ohne Beschreibung.
- Reste aus dem Relaunch. Ein „Disallow: /“ für alle Crawler aus der Testumgebung, das nach dem Livegang stehen bleibt, sperrt Google und alle KI-Suchen auf einmal.
- Sofortige Wirkung erwartet. OpenAI nennt rund 24 Stunden, Google speichert die robots.txt in der Regel bis zu 24 Stunden zwischen. Bereits trainierte Modelle bleiben von einer neuen Sperre unberührt, sie wirkt nur nach vorn.
- Nutzerabrufe übersehen. ChatGPT-User, Perplexity-User und Google-Agent halten sich nicht verlässlich an die robots.txt. Was wirklich vertraulich ist, gehört hinter ein Login. Der Standard RFC 9309 sagt ausdrücklich, dass die Regeln keine Zugriffsberechtigung darstellen.
Eine Datei wird übrigens oft mit der robots.txt verwechselt: die llms.txt. Sie steuert keinen Zugriff, sie erlaubt und sperrt nichts.
So prüfen Sie Ihre Website in 30 Minuten
- Datei aufrufen: Öffnen Sie ihre-domain.de/robots.txt im Browser. Das ist die Fassung, die Crawler sehen, nicht die im CMS.
- KI-Einträge zuordnen: Notieren Sie jede Kennung aus der Tabelle oben, die in der Datei vorkommt, und klären Sie, wer sie wann und warum eingetragen hat.
- Gruppen prüfen: Hat ein KI-Crawler eine eigene Gruppe, müssen dort alle Sperren stehen, die auch für ihn gelten sollen.
- Search Console öffnen: Der robots.txt-Bericht zeigt, welche Datei Google für die wichtigsten Hosts gefunden hat, wann sie zuletzt abgerufen wurde und ob es Fehler gab.
- Hosting und CDN fragen: Lassen Sie sich bestätigen, ob Bot-Schutz oder Firewall KI-Crawler blockieren.
- Server-Logs auswerten: Filtern Sie nach den Kennungen. Weil sich jeder Bot als GPTBot ausgeben kann, gleichen Sie verdächtige Zugriffe mit den IP-Listen ab, die OpenAI und Perplexity veröffentlichen.
Die robots.txt ist ein Prüfpunkt von vielen. Wie er sich in eine vollständige Bestandsaufnahme einfügt, zeigt unser GEO-Audit.
Einordnung: Voraussetzung, kein Hebel
Ein offener OAI-SearchBot sorgt nicht dafür, dass ChatGPT Ihr Unternehmen empfiehlt. Er sorgt nur dafür, dass Ihre Seiten überhaupt in Frage kommen. In unserer Studie waren 40 von 41 Websites mobil ausgelegt, 38 hatten eine Sitemap, nur eine sperrte KI-Crawler. Trotzdem wurden 24 der 41 Unternehmen in keiner ihrer vier KI-Antworten genannt. Die Unterschiede lagen bei Inhalten, Google-Sichtbarkeit und Verzeichnisprofilen: Perplexity stützte sich in 80 von 82 Antworten auf mindestens ein B2B-Verzeichnis.
Wer seine robots.txt geprüft hat, sollte deshalb den Blick auf die Frage richten, ob das Unternehmen bei den Fragen seiner Einkäufer überhaupt vorkommt. Das misst die Nennungsrate über ein festes Set an Prompts, wie im Artikel KI-Sichtbarkeit messen beschrieben. Wie Technik, Inhalte und Messung zusammenspielen, erklären wir auf den Seiten KI-SEO und GEO-Agentur.
Sie möchten wissen, ob Ihre Website für KI-Suchen offen ist und was danach kommt? In der kostenlosen Potenzialanalyse prüfen wir robots.txt, Indexierung, Verzeichnisprofile und Ihre Nennungen in ChatGPT und Perplexity.
Quellen
- OpenAI: Overview of OpenAI Crawlers
- Anthropic: Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity: Perplexity Crawlers
- Google: Common crawlers, darunter Google-Extended
- Google: User-triggered fetchers
- Google: How Google interprets the robots.txt specification
- Google Search Central: AI features and your website
- Google Search Console-Hilfe: robots.txt-Bericht
- Apple: About Applebot
- Common Crawl: CCBot
- Microsoft Bing Webmaster Blog: Steuerung der Inhaltsnutzung in Bing Chat (September 2023)
- Cloudflare: Pressemitteilung zu KI-Crawlern (1. Juli 2025)
- RFC 9309: Robots Exclusion Protocol
- Eigene Studie vertriebsmitarbeiter.ai: KI-Sichtbarkeit von 41 Industrieunternehmen, Messung vom 14.10.2026
Häufige Fragen
Was ist ein KI-Crawler?
Ein KI-Crawler ist ein Programm eines KI-Anbieters, das Webseiten automatisch abruft. Die großen Anbieter unterscheiden dabei drei Aufgaben: Inhalte für das Training von Sprachmodellen sammeln, einen eigenen Suchindex für die Websuche im Assistenten aufbauen und Seiten abrufen, weil ein Nutzer gerade danach fragt. Für jede Aufgabe gibt es eigene Kennungen wie GPTBot, OAI-SearchBot oder ChatGPT-User, die Sie in der robots.txt getrennt behandeln können.
Was passiert, wenn ich GPTBot in der robots.txt sperre?
Laut OpenAI signalisiert eine GPTBot-Sperre, dass Ihre Inhalte nicht für das Training der Basismodelle verwendet werden sollen. Auf die Suchfunktion von ChatGPT hat das keinen direkten Einfluss, denn dafür ist OAI-SearchBot zuständig. Erst wer OAI-SearchBot sperrt, wird laut OpenAI nicht mehr in ChatGPT-Suchantworten gezeigt und kann höchstens noch als Navigationslink erscheinen. Beide Kennungen lassen sich unabhängig voneinander erlauben oder sperren.
Verhindert Google-Extended, dass meine Inhalte in AI Overviews erscheinen?
Nein. Google-Extended ist kein eigener Crawler, sondern ein Steuerzeichen in der robots.txt. Es regelt, ob Inhalte für das Training künftiger Gemini-Modelle und für das Grounding in Gemini-Apps und Vertex AI genutzt werden dürfen. Laut Google beeinflusst es weder die Aufnahme in die Google-Suche noch das Ranking. Was aus einer Seite in AI Overviews und AI Mode erscheint, steuern Sie mit nosnippet, data-nosnippet, max-snippet oder noindex.
Halten sich alle KI-Crawler an die robots.txt?
Die Such- und Trainings-Crawler von OpenAI, Anthropic, Perplexity, Google und Apple beachten die robots.txt nach Angaben der Anbieter. Anders ist es bei Abrufen, die ein Nutzer auslöst: OpenAI schreibt, dass die Regeln für ChatGPT-User nicht unbedingt gelten, Perplexity-User und Googles nutzergesteuerte Abrufer ignorieren sie in der Regel. Grundsätzlich ist die robots.txt laut Standard RFC 9309 eine Bitte und kein Zugriffsschutz. Vertrauliches gehört hinter ein Login.
Sollten Industrieunternehmen KI-Crawler sperren?
Die Such-Crawler sollten offen bleiben, wenn Sie in ChatGPT, Claude oder Perplexity als Lieferant auftauchen wollen. Ob Sie die Trainings-Crawler zulassen, ist eine Abwägung, die Geschäftsführung und Marketing gemeinsam treffen sollten. In unserer Studie mit 41 Industrieunternehmen sperrte nur eine Website KI-Crawler. Die Lücken lagen fast immer bei Inhalten, Google-Sichtbarkeit und Verzeichnisprofilen, nicht bei der robots.txt.