Ein Einkäufer, der einen neuen Lieferanten für Gurtförderer sucht, bekommt von ChatGPT oder Perplexity keine Trefferliste, sondern eine Auswahl von vier oder fünf Firmen, oft mit kurzer Begründung. Ob Ihr Unternehmen darin vorkommt, zeigt Ihnen kein Dashboard von selbst. Es gibt keine Rankingposition zum Nachschlagen, und dieselbe Frage liefert am nächsten Tag eine etwas andere Antwort. Wer KI-Sichtbarkeit messen will, braucht deshalb eine Methode: feste Fragen, feste Zählregeln und genug Wiederholungen.
Dieser Artikel beschreibt das Vorgehen, mit dem wir im Oktober 2026 die KI-Sichtbarkeit von 41 Industrieunternehmen untersucht haben, und zeigt, wie Sie es im eigenen Haus anwenden. Dazu kommen die Zahlen, die Google und Microsoft inzwischen selbst bereitstellen, und eine ehrliche Liste dessen, was keine Messung leisten kann.
Was sich an KI-Sichtbarkeit überhaupt messen lässt
KI-Sichtbarkeit ist kein einzelner Wert. Sie setzt sich aus mindestens vier Ebenen zusammen, die unterschiedliche Fragen beantworten und unterschiedliche Datenquellen brauchen.
| Ebene | Leitfrage | Messinstrument | Datenquelle |
|---|---|---|---|
| Nennung | Werde ich in der Antwort namentlich genannt? | Nennungsrate über ein festes Prompt-Set | Eigene Messung |
| Quelle | Wird meine Website als Beleg verlinkt? | Zählung der zitierten Adressen | Eigene Messung, Bing Webmaster Tools |
| Einblendung bei Google | Wie oft erscheinen Links zu meiner Website in AI Overviews und AI Mode? | Generative-AI-Bericht | Google Search Console |
| Besuch | Kommen Nutzer aus KI-Antworten auf meine Seiten? | Auswertung nach Kanal und Quelle | Web-Analyse |
Für Industrieunternehmen ist die erste Ebene die wichtigste. Ein Konstrukteur, dem fünf Anbieter genannt werden, klickt womöglich keinen Link an und ruft trotzdem zwei Wochen später an. Die Nennung wirkt also auch dann, wenn sie in keiner Web-Analyse auftaucht. Die Kennzahl dafür ist die Nennungsrate: der Anteil relevanter Antworten, in denen Ihr Unternehmen vorkommt. Die folgenden sechs Schritte zeigen, wie Sie diese Zahl belastbar erheben und mit den übrigen Ebenen verbinden.
Schritt 1: Ein Prompt-Set aus echten Einkäuferfragen
Die Qualität der Messung steht und fällt mit den Fragen. Keyword-Tools liefern Suchbegriffe wie „Gurtförderer Hersteller“, aber niemand tippt das so in ein Chatfenster. Dort stehen ganze Sätze mit Kontext: Material, Einsatzort, Stückzahl, Norm. Die besten Quellen für realistische Prompts liegen deshalb im eigenen Haus: Anfragen per E-Mail und Kontaktformular aus den letzten zwölf Monaten, Gesprächsnotizen des Vertriebs, Fragen vom Messestand, Formulierungen aus Ausschreibungen und Support-Tickets.
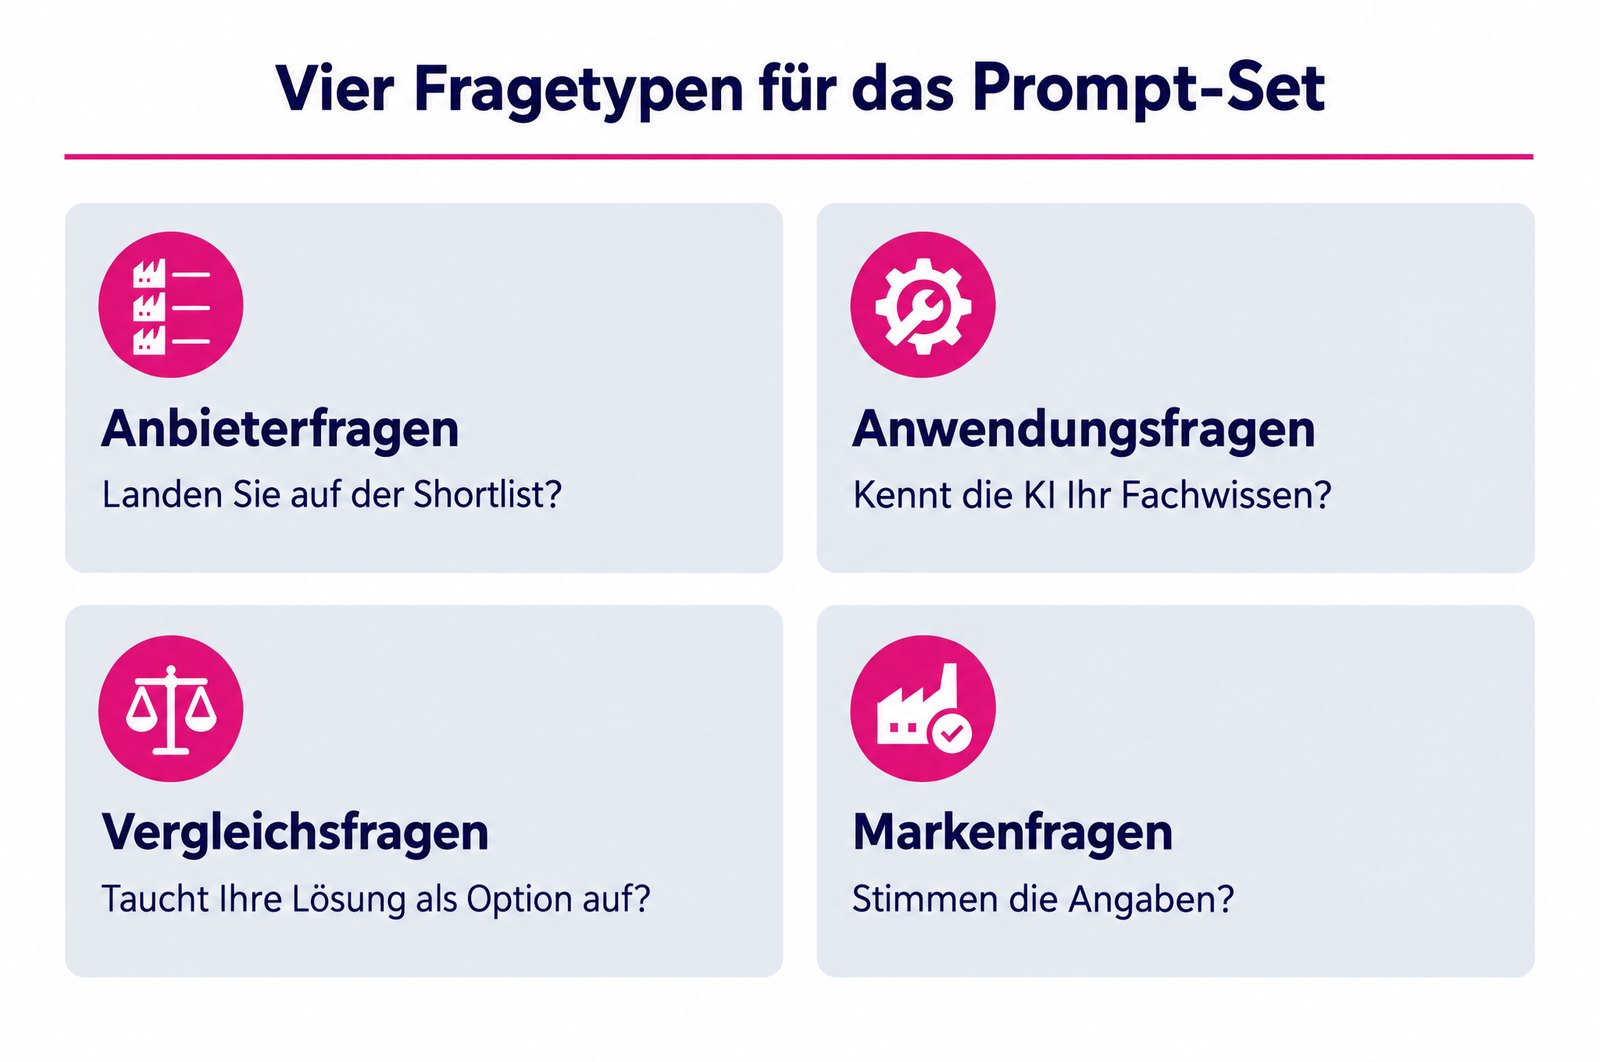
Sortieren Sie die gesammelten Fragen in vier Typen, weil jeder Typ etwas anderes misst:
- Anbieterfragen fragen direkt nach Herstellern oder Lieferanten. Sie messen, ob Sie auf der Shortlist landen.
- Anwendungs- und Problemfragen beschreiben eine technische Aufgabe ohne Anbieterbezug. Sie messen, ob die KI Ihr Fachwissen kennt.
- Vergleichsfragen stellen Verfahren oder Bauarten gegenüber. Hier zeigt sich, ob Ihre Lösung als Option auftaucht.
- Markenfragen fragen direkt nach Ihrem Unternehmen. Sie messen nicht die Sichtbarkeit, sondern die Richtigkeit der Angaben.
Achten Sie darauf, dass das Set die verschiedenen Rollen im Buying Center abbildet: Der Konstrukteur fragt anders als der Einkäufer, der Geschäftsführer anders als die Instandhaltung. Für die meisten Mittelständler reichen 20 bis 30 Prompts. Wichtiger als die Größe ist, dass sich das Set über Monate nicht ändert. Neue Fragen kommen in eine zweite Version mit eigenem Startdatum, damit alte und neue Werte vergleichbar bleiben.
Beispiel: Prompt-Set für einen Hersteller von Gurtförderern
Das folgende Beispiel ist konstruiert. Es zeigt den Aufbau, keine Messergebnisse.
- Anbieterfrage: „Welche Hersteller von Gurtförderern für Schüttgut gibt es in Süddeutschland?“
- Anbieterfrage mit Spezifikation: „Wer fertigt Gurtförderer in ATEX-Ausführung für staubige Umgebungen?“
- Anwendungsfrage: „Welche Förderlösung eignet sich für Holzhackschnitzel bei einer Steigung von mehr als 20 Grad?“
- Vergleichsfrage: „Gurtförderer oder Kettenförderer für abrasive Schüttgüter: Was ist im Unterhalt günstiger?“
- Einkaufsfrage: „Worauf sollte ich bei der Auswahl eines Lieferanten für Förderanlagen achten?“
- Markenfrage: „Was stellt die Firma [Name] her, und wo sitzt sie?“
Die Markenfrage verdient besondere Aufmerksamkeit. In unserer Studie nannte Perplexity ein Unternehmen korrekt mit Namen und Ort, verlinkte aber eine falsche Website. Solche Fehler finden Sie nur, wenn Sie gezielt danach fragen. Warum sie entstehen und wie man sie behebt, beschreibt der Artikel über KI-Halluzinationen zu Unternehmen. Wie Förderanlagenbauer ihre Inhalte für diese Fragen aufstellen, zeigt unsere Seite zur Fördertechnik.
Schritt 2: Systeme und Abfrageweg festlegen
Welche Systeme Sie messen, hängt davon ab, wo Ihre Kunden recherchieren. In der Industrie sind das in der Regel ChatGPT mit Websuche, Perplexity sowie Googles KI-Funktionen AI Overviews und AI Mode. Copilot und Gemini kommen hinzu, wenn Ihre Kunden überwiegend in Microsoft- oder Google-Umgebungen arbeiten. Fragen Sie im Zweifel den Vertrieb, welche Werkzeuge Kunden im Gespräch erwähnen.
Dann entscheiden Sie, wie Sie abfragen. Es gibt zwei Wege:
- Manuell in der Oberfläche: realitätsnah, aber aufwendig. Nutzen Sie ein Konto ohne Verlauf und Personalisierung oder ein abgemeldetes Browserfenster, stellen Sie Sprache und Standort auf Deutschland und aktivieren Sie bei ChatGPT die Websuche.
- Über eine Schnittstelle: reproduzierbar und skalierbar. Für die Studie haben wir ChatGPT (Modell gpt-4o-mini mit Websuche) und Perplexity (Modell sonar) über die DataForSEO-Schnittstelle abgefragt. Die Ergebnisse können von dem abweichen, was ein Nutzer in der App sieht.
Welcher Weg der richtige ist, hängt vom Umfang ab. Wichtig ist, ihn nicht zu wechseln und jede Abfrage zu dokumentieren: Datum, System, Modus, Modell, soweit sichtbar, und Standort. Perplexity zeigt die genutzten Quellen offen an, was die Auswertung erleichtert. Wie das System arbeitet, beschreibt unser Artikel zu Perplexity für Unternehmen.
Schritt 3: Wiederholen, bis der Wert trägt
Sprachmodelle berechnen Wahrscheinlichkeiten. Dieselbe Frage kann deshalb einmal fünf und einmal vier Anbieter liefern, in anderer Reihenfolge oder mit anderen Quellen. Eine einzelne Abfrage ist eine Stichprobe von eins. Erst die Summe vieler Antworten ergibt einen Wert, der sich von Zufall unterscheiden lässt.
Wie viele Antworten Sie brauchen, zeigt eine einfache Rechnung. Die Tabelle gibt an, wie weit eine gemessene Nennungsrate von etwa 20 Prozent allein durch Zufall schwanken kann.
| Ausgewertete Antworten | Ungefähre Schwankungsbreite (95 %) |
|---|---|
| 30 | ± 14 Prozentpunkte |
| 60 | ± 10 Prozentpunkte |
| 90 | ± 8 Prozentpunkte |
| 150 | ± 6 Prozentpunkte |
| 300 | ± 4,5 Prozentpunkte |
Die Werte gelten unter der vereinfachenden Annahme voneinander unabhängiger Antworten. Wiederholungen desselben Prompts sind das nicht ganz, die tatsächliche Unsicherheit ist eher etwas größer. Für die Praxis heißt das: Wer mit 30 Antworten misst und von einem Monat zum nächsten fünf Prozentpunkte gewinnt, hat sehr wahrscheinlich Rauschen gemessen. Mit 25 Prompts, drei Durchläufen und zwei Systemen kommen Sie auf 150 Antworten je Messung. Das ist der Bereich, in dem sich Veränderungen deuten lassen. Verteilen Sie die Durchläufe auf mehrere Tage, damit kurzfristige Schwankungen der Systeme nicht alle in dieselbe Richtung zeigen.
Unsere Studie illustriert die Grenze. Über alle 164 Antworten ist die Nennungsrate von 23 Prozent eine brauchbare Größenordnung. Für das einzelne Unternehmen lagen dagegen nur vier Antworten vor. Deshalb haben wir die Ergebnisse zusammengefasst veröffentlicht und nicht als Bewertung einzelner Firmen.
Schritt 4: Zählregeln vor der ersten Messung festlegen
Was als Nennung zählt, muss vor der ersten Abfrage feststehen, sonst entscheidet die Laune der auswertenden Person. In der Studie galt: Eine Nennung liegt vor, wenn Unternehmensname oder Domain in der Antwort oder in den verlinkten Quellen vorkommt. Legen Sie außerdem fest, welche Namensvarianten mitzählen: Rechtsform, Abkürzungen, frühere Firmennamen, Produktmarken.
Erfassen Sie neben dem Ja oder Nein auch die Qualität der Nennung, etwa mit vier Codes: aktiv empfohlen, neutral genannt, nur als Quelle verlinkt, fehlerhaft beschrieben. Eine Empfehlung mit korrekten Angaben ist deutlich mehr wert als ein Name am Ende einer langen Aufzählung, und eine fehlerhafte Nennung ist ein eigenes Arbeitspaket.
Notieren Sie für jede Antwort zusätzlich zwei Dinge, die später viel Arbeit sparen. Erstens die genannten Wettbewerber, denn ohne Vergleich bleibt jede Nennungsrate eine Zahl ohne Maßstab. Zweitens die verlinkten Quellen. In unserer Studie stützte sich Perplexity in 80 von 82 Antworten auf mindestens ein B2B-Verzeichnis, ChatGPT griff in 16 von 82 Antworten auf Einträge aus Google Maps zurück. Wer die Quellen kennt, weiß, wo er ansetzen muss. Eine Tabelle mit diesen Spalten genügt: Datum, System, Prompt-Nummer, Durchlauf, genannt ja oder nein, Qualitätscode, Position in der Aufzählung, Wettbewerber, Quellen.
Schritt 5: Googles und Microsofts eigene Zahlen ergänzen
Seit 2026 liefern die Suchmaschinenbetreiber selbst Daten zur Sichtbarkeit in ihren KI-Funktionen. Sie ersetzen die Prompt-Messung nicht, ergänzen sie aber um eine Ebene, die Sie selbst nicht erheben können.
Google Search Console: Am 3. Juni 2026 hat Google eigene Leistungsberichte für generative KI-Funktionen vorgestellt, seit dem 31. August 2026 stehen sie allen Websites weltweit zur Verfügung. Der Bericht für die Suche zeigt Impressionen in AI Overviews und AI Mode, also wie oft Links zu Ihrer Website dort eingeblendet wurden. Aufschlüsseln lässt er sich nach Seiten, Ländern, Geräten und Zeitraum. Mehrere Links derselben Website in einer KI-Antwort zählen laut Google-Hilfe als eine Impression. Klicks und Suchanfragen enthält der Bericht nicht. Seit dem 24. September 2026 gibt es zudem einen Filter für multimodale Suchen, etwa über Google Lens. Die Impressionen aus KI-Funktionen fließen weiterhin auch in den normalen Leistungsbericht ein.
Praktisch nutzen Sie den Bericht, um zu sehen, welche Seiten Google in KI-Antworten verwendet, und um diese Liste mit Ihrem Prompt-Set abzugleichen. Erscheinen vor allem Glossar- und Ratgeberseiten, aber kaum Produktseiten, ist das ein Hinweis, wo inhaltlich nachgebessert werden sollte.
Bing Webmaster Tools: Microsoft hat am 10. Februar 2026 den Bericht „AI Performance“ als öffentliche Vorschau eingeführt. Er zeigt, wie oft Seiten als Quelle in Antworten von Copilot, in KI-Zusammenfassungen bei Bing und bei ausgewählten Partnern zitiert wurden, welche Seiten das waren und mit welchen Suchphrasen die KI die Inhalte abgerufen hat. Klicks zeigt auch dieser Bericht nicht.
Für die Auswahl externer Tools gilt eine Warnung von Google selbst. Im Leitfaden zur KI-Suche heißt es sinngemäß: Seien Sie vorsichtig bei Drittanbieter-Tools, die Ranking-Erfolg versprechen oder angeblich „interne“ Google-Metriken nutzen, denn kein Drittanbieter hat Zugriff auf Googles interne Ranking- oder KI-Systeme. Seriöse Tools stellen Fragen und zählen Antworten, genau wie Sie.
Schritt 6: Rhythmus, Protokoll und Einordnung
Monatlich zu messen ist für die meisten Industrieunternehmen der richtige Takt. Kürzere Abstände zeigen vor allem die Schwankung der Modelle. Halten Sie jede Messung mit Datum und Versionsstand des Prompt-Sets fest und notieren Sie Ereignisse, die Werte erklären können: Relaunch, neue Verzeichnisprofile, Modellwechsel bei einem Anbieter.
Die eigentliche Arbeit beginnt bei der Auswertung nach Prompt-Typ. Einige Muster tauchen immer wieder auf:
| Muster in der Messung | Naheliegende Ursache | Nächster Prüfschritt |
|---|---|---|
| Bei Anbieterfragen nie genannt, Quellen sind Verzeichnisse | Verzeichnisprofile fehlen oder sind unvollständig | Profile bei wlw, europages und lieferanten.de prüfen |
| ChatGPT nennt Wettbewerber mit Sternebewertung | Schwaches Unternehmensprofil bei Google | Profil und Bewertungen ausbauen |
| Genannt, aber mit falschen Angaben | Uneinheitliche Firmendaten im Netz | Name, Adresse, Domain überall angleichen |
| Bei Anwendungsfragen nie genannt | Fachwissen fehlt auf der Website | Leistungsseiten mit technischen Details ausbauen |
| Search Console zeigt Impressionen, Prompts zeigen keine Nennung | Seiten dienen als Quelle, die Marke fällt aber nicht | Prüfen, ob die Seiten das Unternehmen klar benennen |
Das zweite Muster deckt sich mit unserer Studie, in der ChatGPT bei Anbieterfragen auf Google-Maps-Einträge zurückgriff. Wie Sie das Google-Unternehmensprofil für B2B nutzen, beschreibt ein eigener Ratgeber. Eine strukturierte Prüfung aller Punkte von Technik bis Verzeichnis bietet der GEO-Audit.
Was keine Messung leisten kann
Zur ehrlichen Einordnung gehören die Grenzen. Erstens kennt niemand außerhalb von OpenAI, Google oder Perplexity die tatsächliche Häufigkeit einzelner Prompts. Tools schätzen Volumen aus eigenen Datenbanken, belastbare Nachfragedaten wie bei Google-Suchbegriffen gibt es nicht. Zweitens personalisieren die Systeme: Gespeicherte Erinnerungen, Standort und Gesprächsverlauf verändern Antworten, die Messung bildet einen neutralen Nutzer ab, keinen echten. Drittens ändern Anbieter ihre Modelle ohne Vorankündigung, ein Sprung in den Werten kann also an der Messung liegen statt an Ihrer Website.
Viertens zeigt eine Messung Zusammenhänge, keine Ursachen. In unserer Studie waren die genannten Unternehmen bei Google rund zehnmal sichtbarer als die nicht genannten. Das ist ein deutlicher Hinweis, aber kein Beweis. Und fünftens ersetzt Messen keine Substanz: Google stellt im Leitfaden vom Mai 2026 klar, dass es für AI Overviews und AI Mode keine Spezialoptimierung gibt und Versuche, KI-Antworten zu manipulieren, unter die Spam-Richtlinien fallen.
Fazit: Messen heißt Regeln einhalten
KI-Sichtbarkeit messen ist kein Hexenwerk, aber Handarbeit mit Disziplin. Ein festes Prompt-Set aus echten Kundenfragen, ein dokumentierter Abfrageweg, genug Wiederholungen und klare Zählregeln ergeben eine Nennungsrate, mit der Sie arbeiten können. Search Console und Bing Webmaster Tools ergänzen das Bild um die Sicht der Suchmaschinen. Zusammen zeigen sie, wo Sie stehen und welche Maßnahme als Nächstes zählt.
Wenn Sie diese Messung nicht selbst aufbauen möchten, übernehmen wir das in der Potenzialanalyse: Wir entwickeln das Prompt-Set mit Ihrem Vertrieb, messen Ihre Nennungen in ChatGPT, Perplexity und Google und ordnen die Ergebnisse im Vergleich zu Ihren Wettbewerbern ein. Mehr zu unserem Vorgehen lesen Sie auf den Seiten GEO-Agentur und GEO als Leistung, oder Sie vereinbaren direkt ein Gespräch.
Quellen
- Google Search Central: Optimizing your website for generative AI features on Google Search, Leitfaden vom 15.05.2026, u. a. zur Messung und zu Drittanbieter-Tools
- Google Search Central Blog: Introducing Search Generative AI performance reports in Search Console, 03.06.2026, mit Hinweis zur Freigabe für alle Websites am 31.08.2026
- Search Console-Hilfe: Generative AI performance report (Search)
- Google Search Central Blog: Web multimodal Search performance reporting in Search Console, 24.09.2026
- Bing Webmaster Blog: Introducing AI Performance in Bing Webmaster Tools Public Preview, 10.02.2026
- Google Search Central: Spam-Richtlinien für die Google-Websuche
- Eigene Studie vertriebsmitarbeiter.ai: KI-Sichtbarkeit von 41 Industriefirmen, Messung vom 14.10.2026
Häufige Fragen
Wie misst man die KI-Sichtbarkeit eines Unternehmens?
Mit einem festen Set aus 20 bis 30 Fragen, wie sie Kunden tatsächlich stellen, das regelmäßig in ChatGPT mit Websuche, Perplexity und Googles KI-Funktionen geprüft wird. Jede Frage wird mehrfach gestellt, weil die Antworten schwanken. Gezählt wird nach vorher festgelegten Regeln, ob das Unternehmen genannt wird, wie es beschrieben wird und welche Quellen die KI nutzt. Daraus ergibt sich die Nennungsrate. Ergänzend liefert die Search Console Impressionen in AI Overviews und AI Mode.
Wie oft muss man einen Prompt wiederholen?
Für ein belastbares Ergebnis drei Durchläufe je Prompt und System, verteilt über mehrere Tage. Entscheidend ist die Gesamtzahl der ausgewerteten Antworten: Bei 30 Antworten schwankt eine Nennungsrate um 20 Prozent rechnerisch um rund 14 Prozentpunkte, bei 150 Antworten nur noch um rund 6 Prozentpunkte. Wer mit 25 Prompts, drei Durchläufen und zwei Systemen arbeitet, kommt auf 150 Antworten je Messung und kann Veränderungen von Monat zu Monat sinnvoll deuten.
Was zeigt der Search-Console-Bericht zu generativer KI?
Der Bericht zeigt, wie oft Links zu Ihrer Website in AI Overviews und AI Mode eingeblendet wurden, aufgeschlüsselt nach Seiten, Ländern, Geräten und Zeitraum. Google hat ihn am 3. Juni 2026 vorgestellt, seit dem 31. August 2026 steht er allen Websites weltweit zur Verfügung. Er enthält keine Klicks und keine Suchanfragen. Sie sehen also, welche Seiten in KI-Funktionen erscheinen, aber nicht, bei welcher Frage. Die namentliche Nennung in ChatGPT oder Perplexity deckt er nicht ab.
Reicht ein Tool, um KI-Sichtbarkeit zu messen?
Ein Tool kann die Abfragen automatisieren, die Methode ersetzt es nicht. Prompt-Set, Zählregeln und Wettbewerberauswahl müssen Sie selbst festlegen, sonst misst das Tool die falschen Fragen. Google warnt ausdrücklich vor Drittanbietern, die Ranking-Erfolg versprechen oder angeblich interne Google-Metriken nutzen: Kein Drittanbieter hat Zugriff auf Googles interne Ranking- oder KI-Systeme. Für 20 bis 30 Prompts genügt anfangs eine sauber geführte Tabelle.
Wie oft sollte man die KI-Sichtbarkeit messen?
Monatlich ist für die meisten Industrieunternehmen ein guter Rhythmus. Kürzere Abstände zeigen vor allem die normale Schwankung der Modelle, keine echte Veränderung. Wichtiger als die Frequenz ist, dass Prompt-Set, Systeme und Zählregeln über Monate gleich bleiben. Nach größeren Maßnahmen wie einem Relaunch oder überarbeiteten Verzeichnisprofilen lohnt sich eine Zusatzmessung, wobei Effekte oft erst nach Wochen sichtbar werden.